✅SpringAI中如何使用Skill?(Agent)
前面我们基于Qoder开发了一个帮我们做简历评估的Skill,我们接着把他集成到我们的应用代码中我们自己开发的Agent中。
Spring AI本身是不支持Skill的,但是Spring AI Alibaba 1.1.2版本发布了,他是支持Skill了的。我们接着一步一步的把这个简历评估的Skill集成进来。
增加依赖
在pom中把spring ai alibaba的版本升级到1.1.2.0
1
2
3
4
5
6
7
8
9
10
| <dependency>
<groupId>com.alibaba.cloud.ai</groupId>
<artifactId>spring-ai-alibaba-starter-dashscope</artifactId>
<version>1.1.2.0</version>
</dependency>
<dependency>
<groupId>com.alibaba.cloud.ai</groupId>
<artifactId>spring-ai-alibaba-agent-framework</artifactId>
<version>1.1.2.0</version>
</dependency>
|
增加Skill
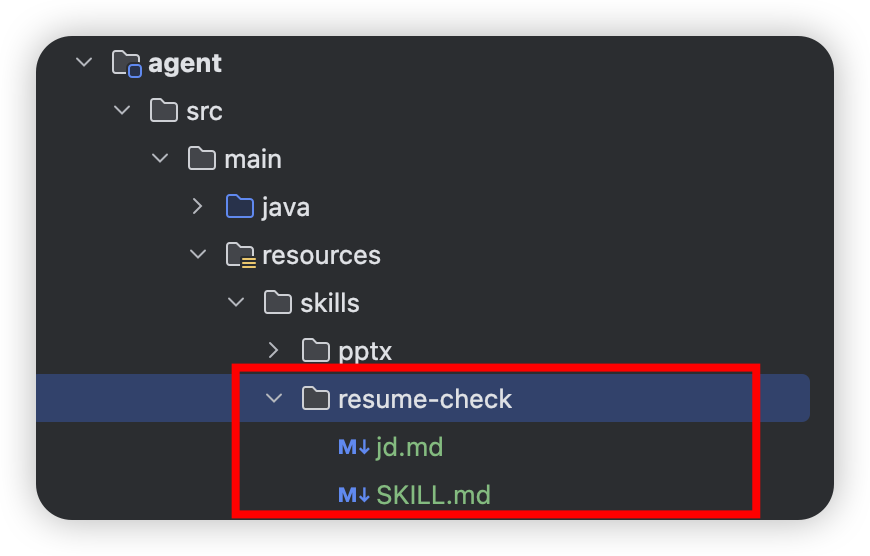
在我们的项目的classpath下,创建一个skill目录,再把resume-check这个skill放进去,如:
工具定义
接着,我们需要提供工具,提供一个可以读取文件的工具,包括PDF、MD的读取:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
| package cn.hollis.llm.HelloLlm.agent.react.tools;
import org.apache.pdfbox.Loader;
import org.apache.pdfbox.pdmodel.PDDocument;
import org.apache.pdfbox.text.PDFTextStripper;
import org.apache.poi.hssf.usermodel.HSSFWorkbook;
import org.apache.poi.hwpf.HWPFDocument;
import org.apache.poi.hwpf.extractor.WordExtractor;
import org.apache.poi.sl.usermodel.TextShape;
import org.apache.poi.xslf.usermodel.XMLSlideShow;
import org.apache.poi.xssf.usermodel.XSSFWorkbook;
import org.apache.poi.xwpf.usermodel.XWPFDocument;
import org.apache.poi.xwpf.usermodel.XWPFParagraph;
import org.apache.poi.ss.usermodel.*;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.ai.tool.annotation.Tool;
import org.springframework.ai.tool.annotation.ToolParam;
import java.io.*;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
public class FileReaderTool {
private static final Logger log = LoggerFactory.getLogger(FileReaderTool.class);
private static final int MAX_CHARS = 8000;
@Tool(description = """ 读取本地文件并返回其文本内容。 支持格式: - PDF (.pdf) - Word (.docx / .doc) - Excel (.xlsx / .xls) —— 返回所有 Sheet 的表格文本 - PowerPoint (.pptx) —— 返回所有幻灯片的文字 - 纯文本 (.txt / .md / .csv / .log / .xml / .json / .yaml / .yml / .properties) 参数 filePath 为文件的绝对路径。 对于 PDF 文件,可选参数 startPage / endPage 指定读取页码范围(从 1 开始);其他格式忽略此参数。 若文本过长会自动截断并在末尾注明剩余字符数。 """) public String read_file(
@ToolParam(description = "文件的绝对路径,支持 pdf/docx/doc/xlsx/xls/pptx/txt/md/csv 等格式") String filePath, @ToolParam(required = false, description = "【仅 PDF 有效】起始页码(从 1 开始,默认第 1 页)") Integer startPage, @ToolParam(required = false, description = "【仅 PDF 有效】结束页码(含,默认最后一页)") Integer endPage) {
if (filePath == null || filePath.isBlank()) {
return "Error: filePath 不能为空"; }
File file = new File(filePath);
if (!file.exists()) {
return "Error: 文件不存在 -> " + filePath; }
if (!file.canRead()) {
return "Error: 文件无读取权限 -> " + filePath; }
String ext = getExtension(file.getName()).toLowerCase();
try {
return switch (ext) {
case "pdf" -> readPdf(file, startPage, endPage);
case "docx" -> readDocx(file);
case "doc" -> readDoc(file);
case "xlsx" -> readExcel(file, false);
case "xls" -> readExcel(file, true);
case "pptx" -> readPptx(file);
default -> readText(file); }; }
catch (Exception e) {
log.error("读取文件失败: {}", filePath, e);
return "Error: 读取文件失败 -> " + e.getMessage(); } }
if (from > total) {
return String.format("Error: startPage(%d) 超过文件总页数(%d)", from, total); }
PDFTextStripper stripper = new PDFTextStripper(); stripper.setStartPage(from); stripper.setEndPage(to); stripper.setSortByPosition(true);
String text = stripper.getText(doc);
String header = String.format("[PDF 共 %d 页,本次读取第 %d-%d 页]\n\n", total, from, to);
return header + truncate(text); } }
StringBuilder sb = new StringBuilder(); DataFormatter formatter = new DataFormatter();
for (int si = 0; si < wb.getNumberOfSheets(); si++) {
Sheet sheet = wb.getSheetAt(si); sb.append("=== Sheet: ").append(sheet.getSheetName()).append(" ===\n");
for (Row row : sheet) {
StringBuilder rowSb = new StringBuilder();
for (Cell cell : row) {
if (rowSb.length() > 0) rowSb.append("\t"); rowSb.append(formatter.formatCellValue(cell)); }
String rowStr = rowSb.to
String().trim();
if (!rowStr.isEmpty()) {
sb.append(rowStr).append("\n"); } }
sb.append("\n"); }
String ext = isOld ? ".xls" : ".xlsx";
return "[Excel (" + ext + ") 共 " + wb.getNumberOfSheets() + " 个 Sheet]\n\n" + truncate(sb.to
String()); } }
private String getExtension(String filename) {
int dot = filename.lastIndexOf('.');
return (dot >= 0 && dot < filename.length() - 1) ? filename.substring(dot + 1) : ""; }
}
|
以上是一个文件读取工具,支持读取各种类型的工具,当然,需要增加依赖:
1
2
3
|
<!-- PDF 读取:Apache PDFBox --><dependency>    <groupId>org.apache.pdfbox</groupId>    <artifactId>pdfbox</artifactId>    <version>3.0.3</version></dependency>
<!-- Office 文档读取:Apache POI(Word/Excel/PPT) --><dependency>    <groupId>org.apache.poi</groupId>    <artifactId>poi-ooxml</artifactId>    <version>5.3.0</version></dependency><!-- 兼容旧版 .doc / .xls 格式 --><dependency>    <groupId>org.apache.poi</groupId>    <artifactId>poi-scratchpad</artifactId>    <version>5.3.0</version></dependency>
|
修改SKILL.md
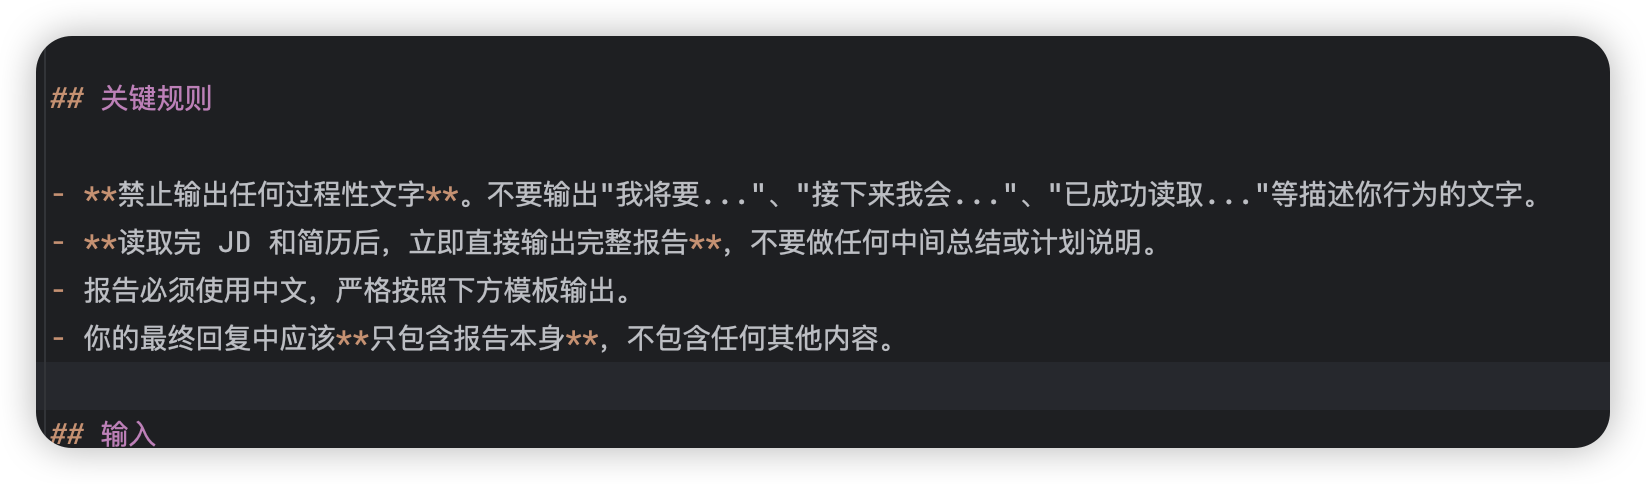
我们还需要修改一下SKILL.md,把其中使用的Read工具替换为我们自定义的read_file工具:
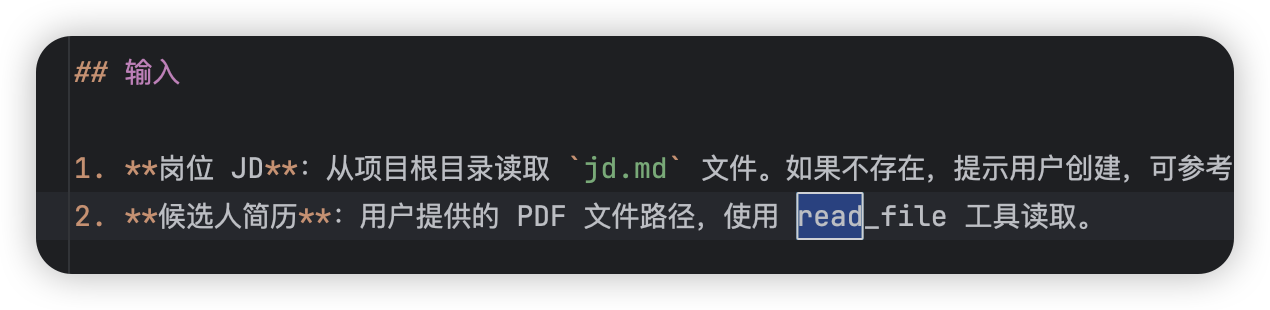
并且这个jd.md也可以改成markdown语法(如果出了问题的话),指定具体位置。
定义Agent
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
| package cn.hollis.llm.HelloLlm.agent.react.controller;
import cn.hollis.llm.HelloLlm.agent.react.tools.FileReaderTool;
import com.alibaba.cloud.ai.graph.RunnableConfig;
import com.alibaba.cloud.ai.graph.agent.ReactAgent;
import com.alibaba.cloud.ai.graph.agent.hook.shelltool.ShellToolAgentHook;
import com.alibaba.cloud.ai.graph.agent.hook.skills.SkillsAgentHook;
import com.alibaba.cloud.ai.graph.agent.tools.ShellTool2;
import com.alibaba.cloud.ai.graph.checkpo
int.savers.MemorySaver;
import com.alibaba.cloud.ai.graph.exception.GraphRunnerException;
import com.alibaba.cloud.ai.graph.skills.regis
try.SkillRegis
try;
import com.alibaba.cloud.ai.graph.skills.regis
try.classpath.ClasspathSkillRegis
try;
import org.springframework.ai.chat.messages.AssistantMessage;
import org.springframework.ai.chat.model.ChatModel;
import org.springframework.ai.support.ToolCallbacks;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;
import java.util.List;
@RestController
@RequestMapping("/skill")
public class SkillController {
@Autowired private ChatModel dashScopeChatModel;
@RequestMapping("/resumeCheck") public String resumeCheck(String message) throws GraphRunnerException {
RunnableConfig config = RunnableConfig.builder() .threadId("10088")
AssistantMessage assistantMessage = agent.call(message, config);
return assistantMessage.getText(); }
}
|
我们一共给这个Agent提供了两个Hook和一个工具,一个Skills Hook,用于读取和查看Skill;一个Shell Hook,用于执行shell命令;一个文件读取工具,用来读取简历和JD。
SkillsAgentHook和ShellToolAgentHook是Spring AI Alibaba中内置的Hook,这个我们后面介绍一下他的实现原理,这里大家先这么用。
简历上传到MinIO
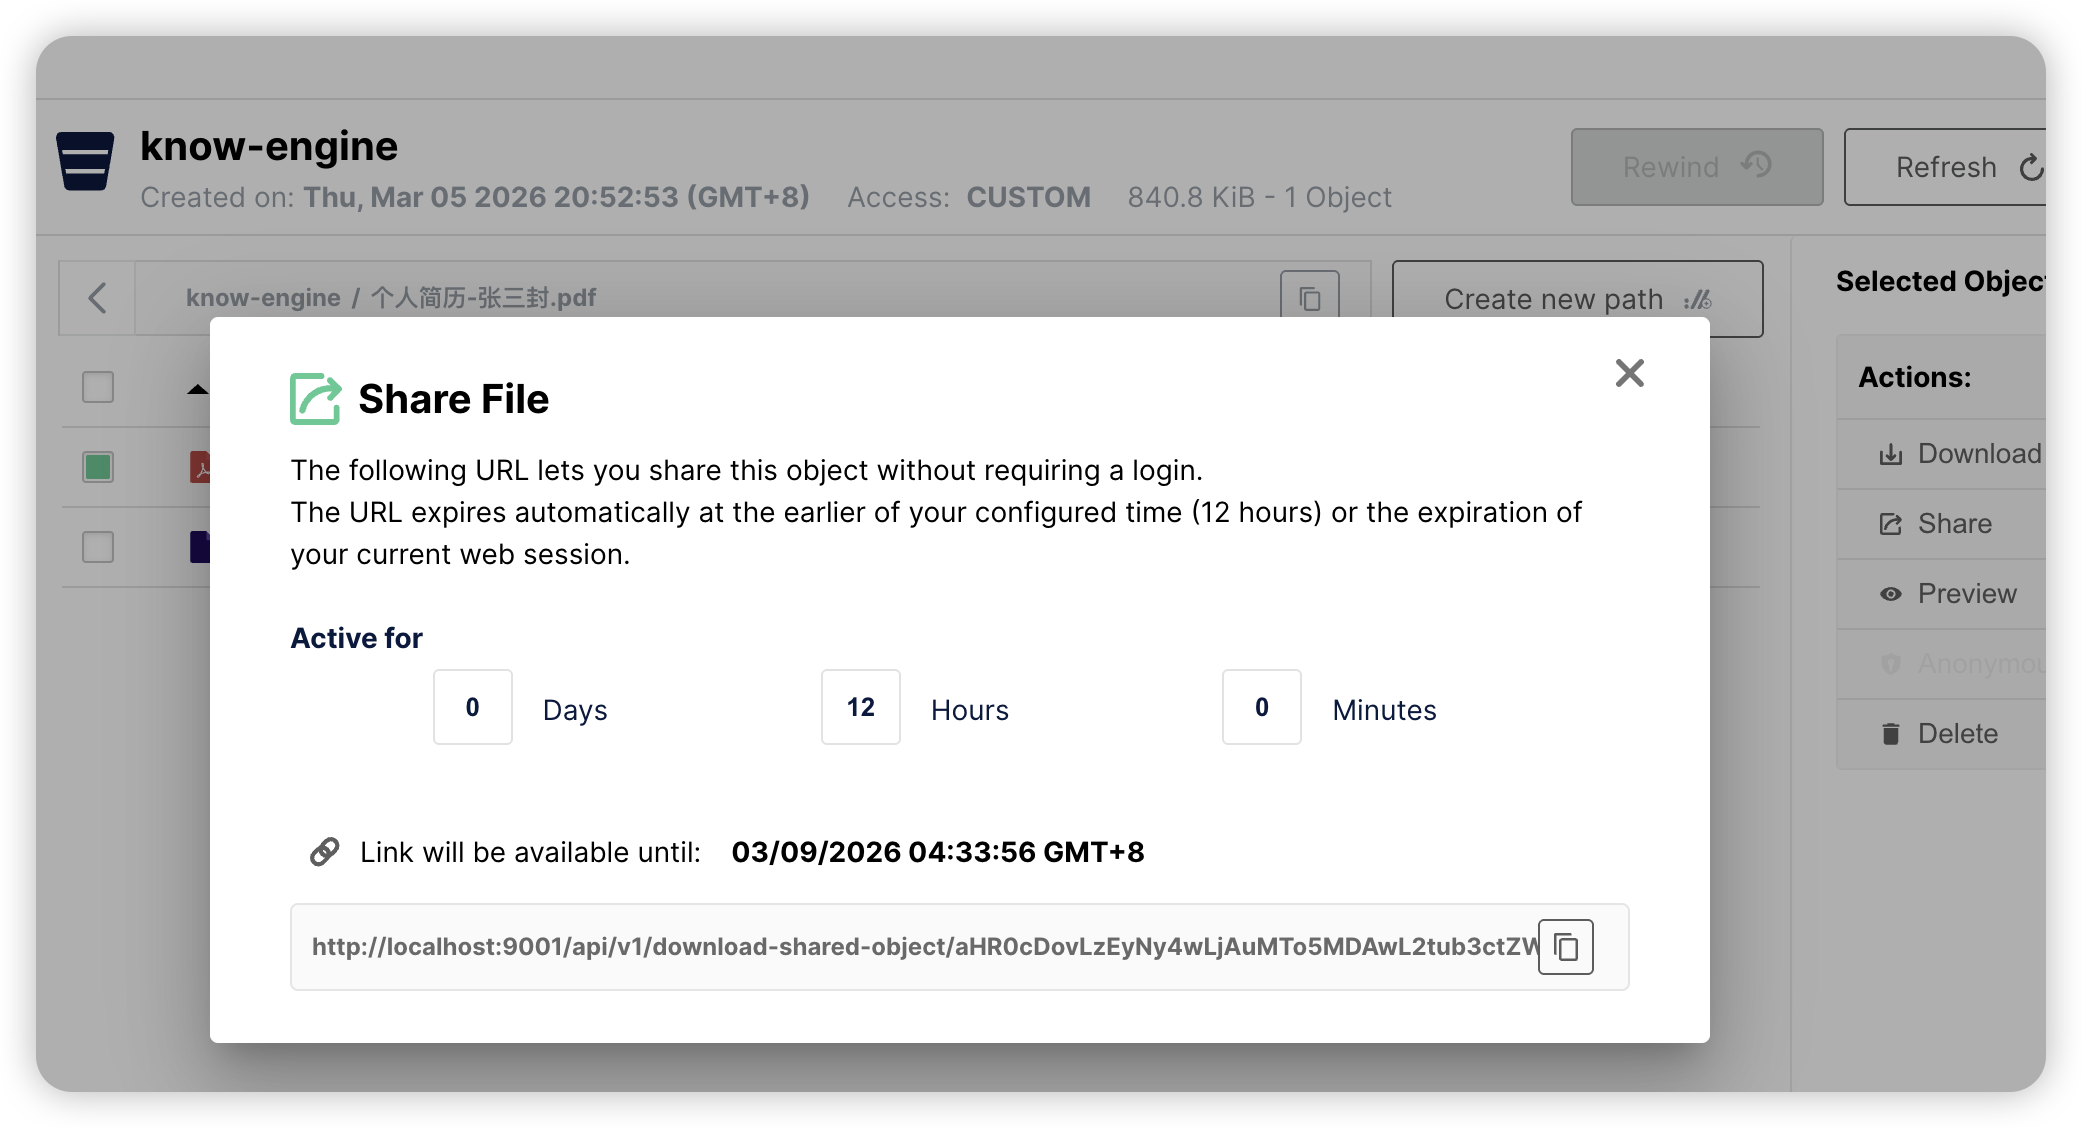
把我们之前用的那个pdf简历上传到本地minio中,然后再通过share获取到一个下载地址。
或者你把他上传到其他地方也行,只要能拿到一个url可以访问这个PDF就行。或者是写一个前端页面,提供PDF的上传也可以。
发起请求
启动应用,然后访问:
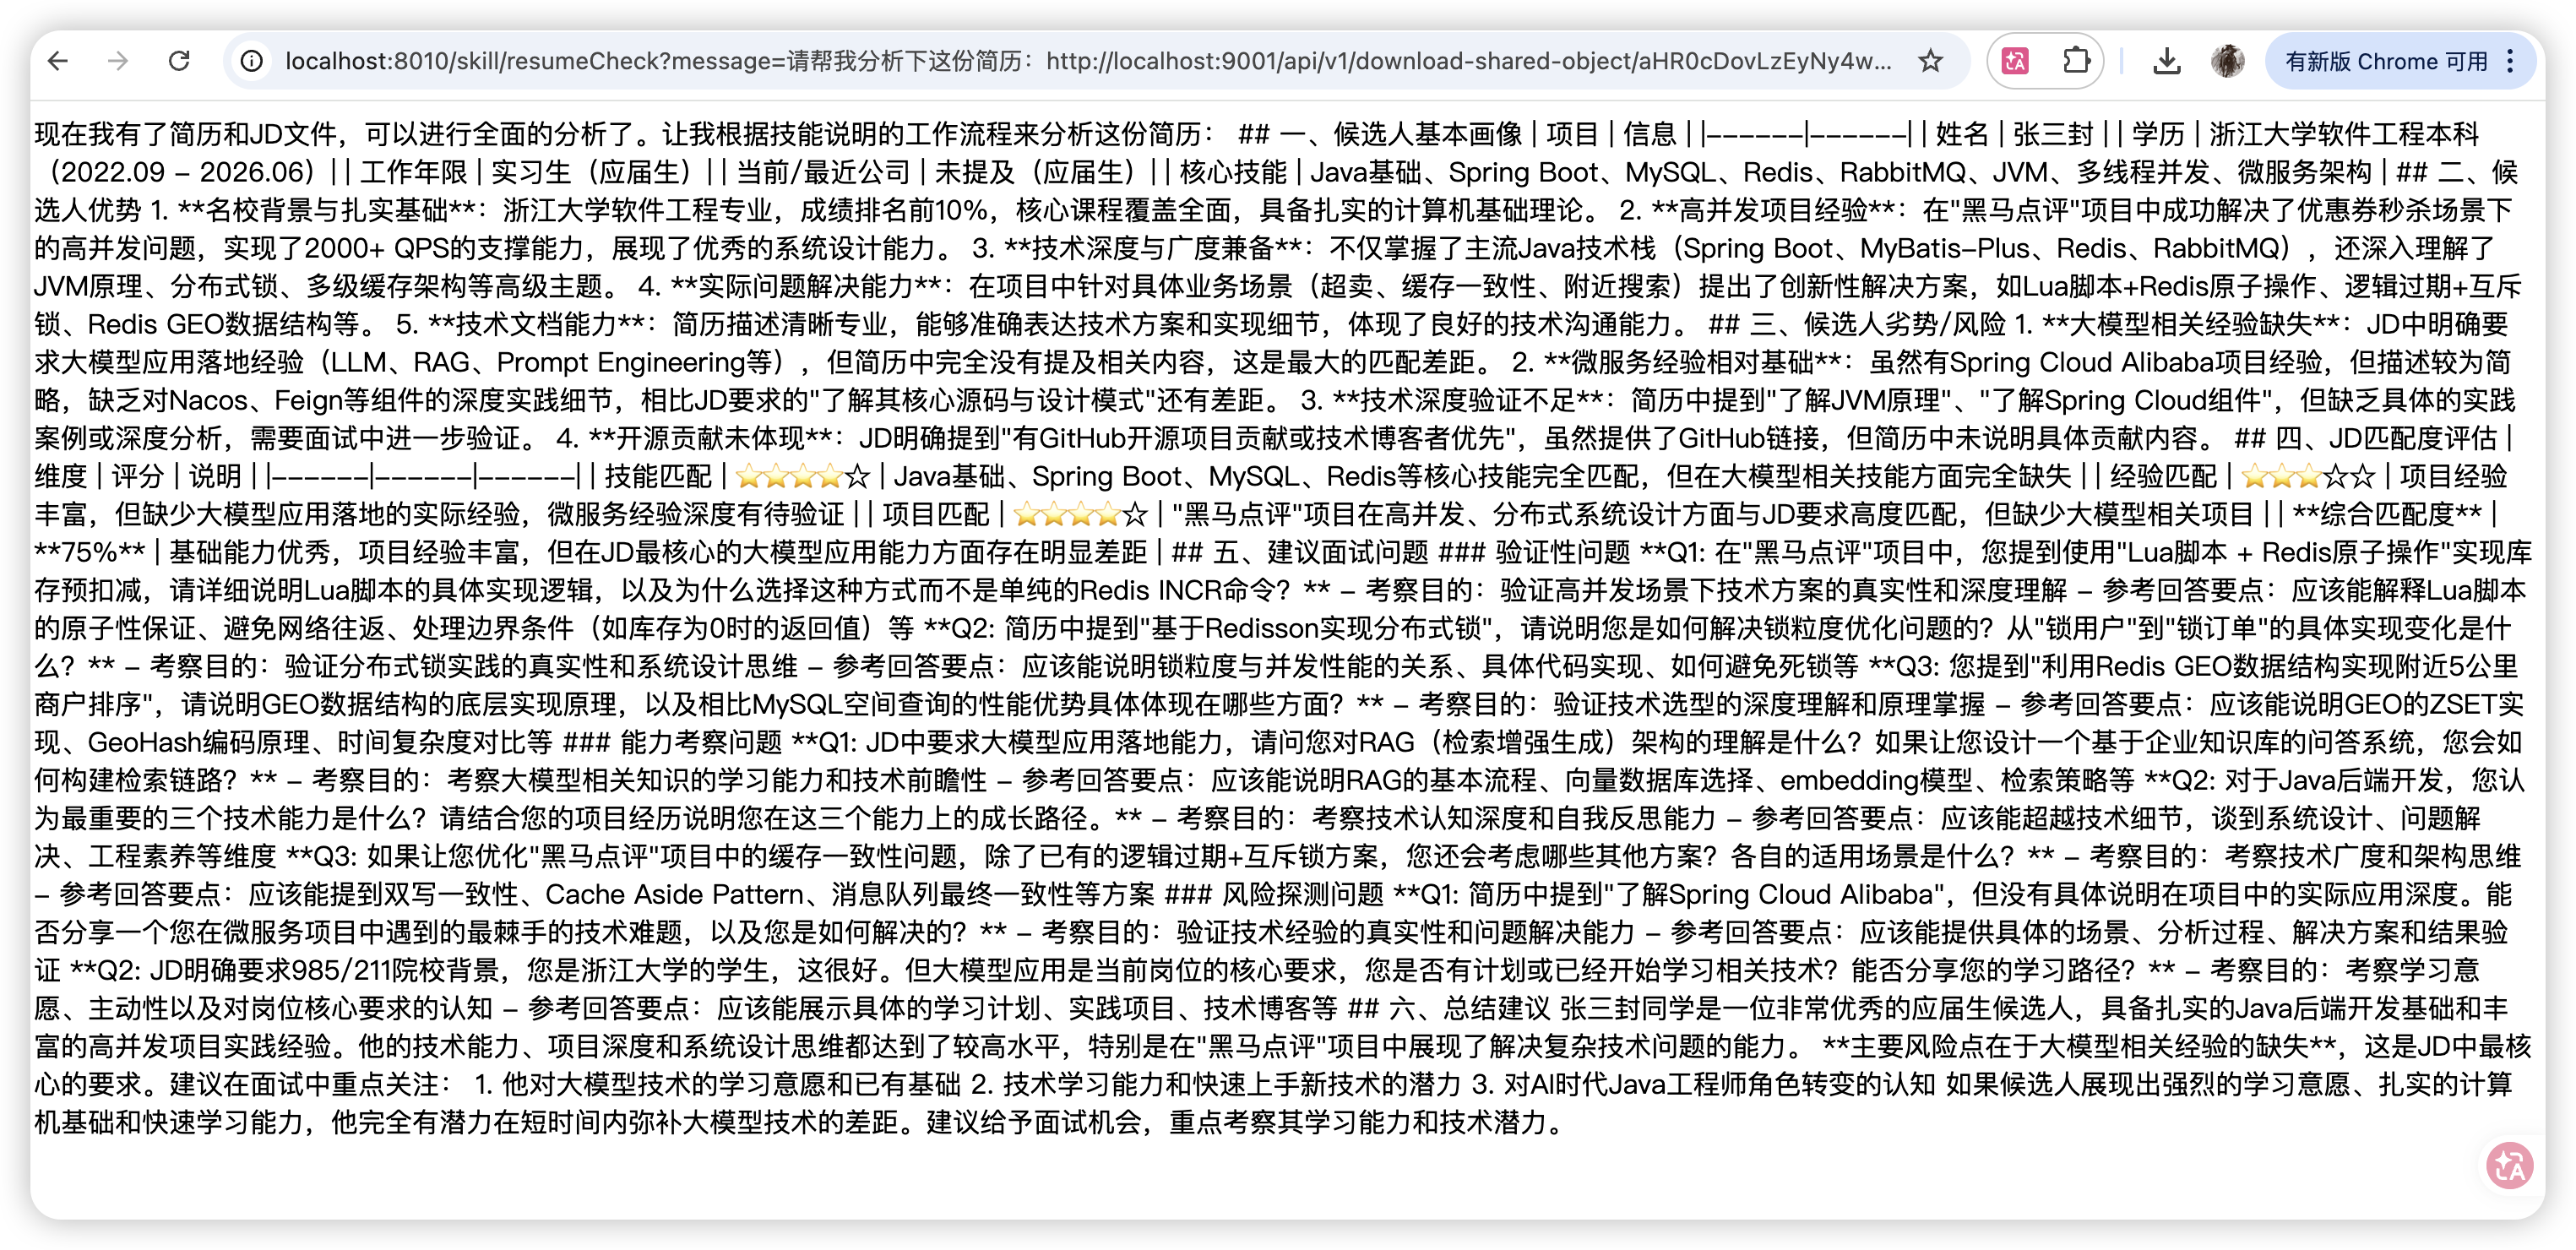
http://localhost:8010/skill/resumeCheck?message=请帮我分析下这个简历:http://localhost:9001/api/v1/download-shared-object/xxxxxxxx
把上面的地址换成你自己的pdf的文件地址。
输出结果
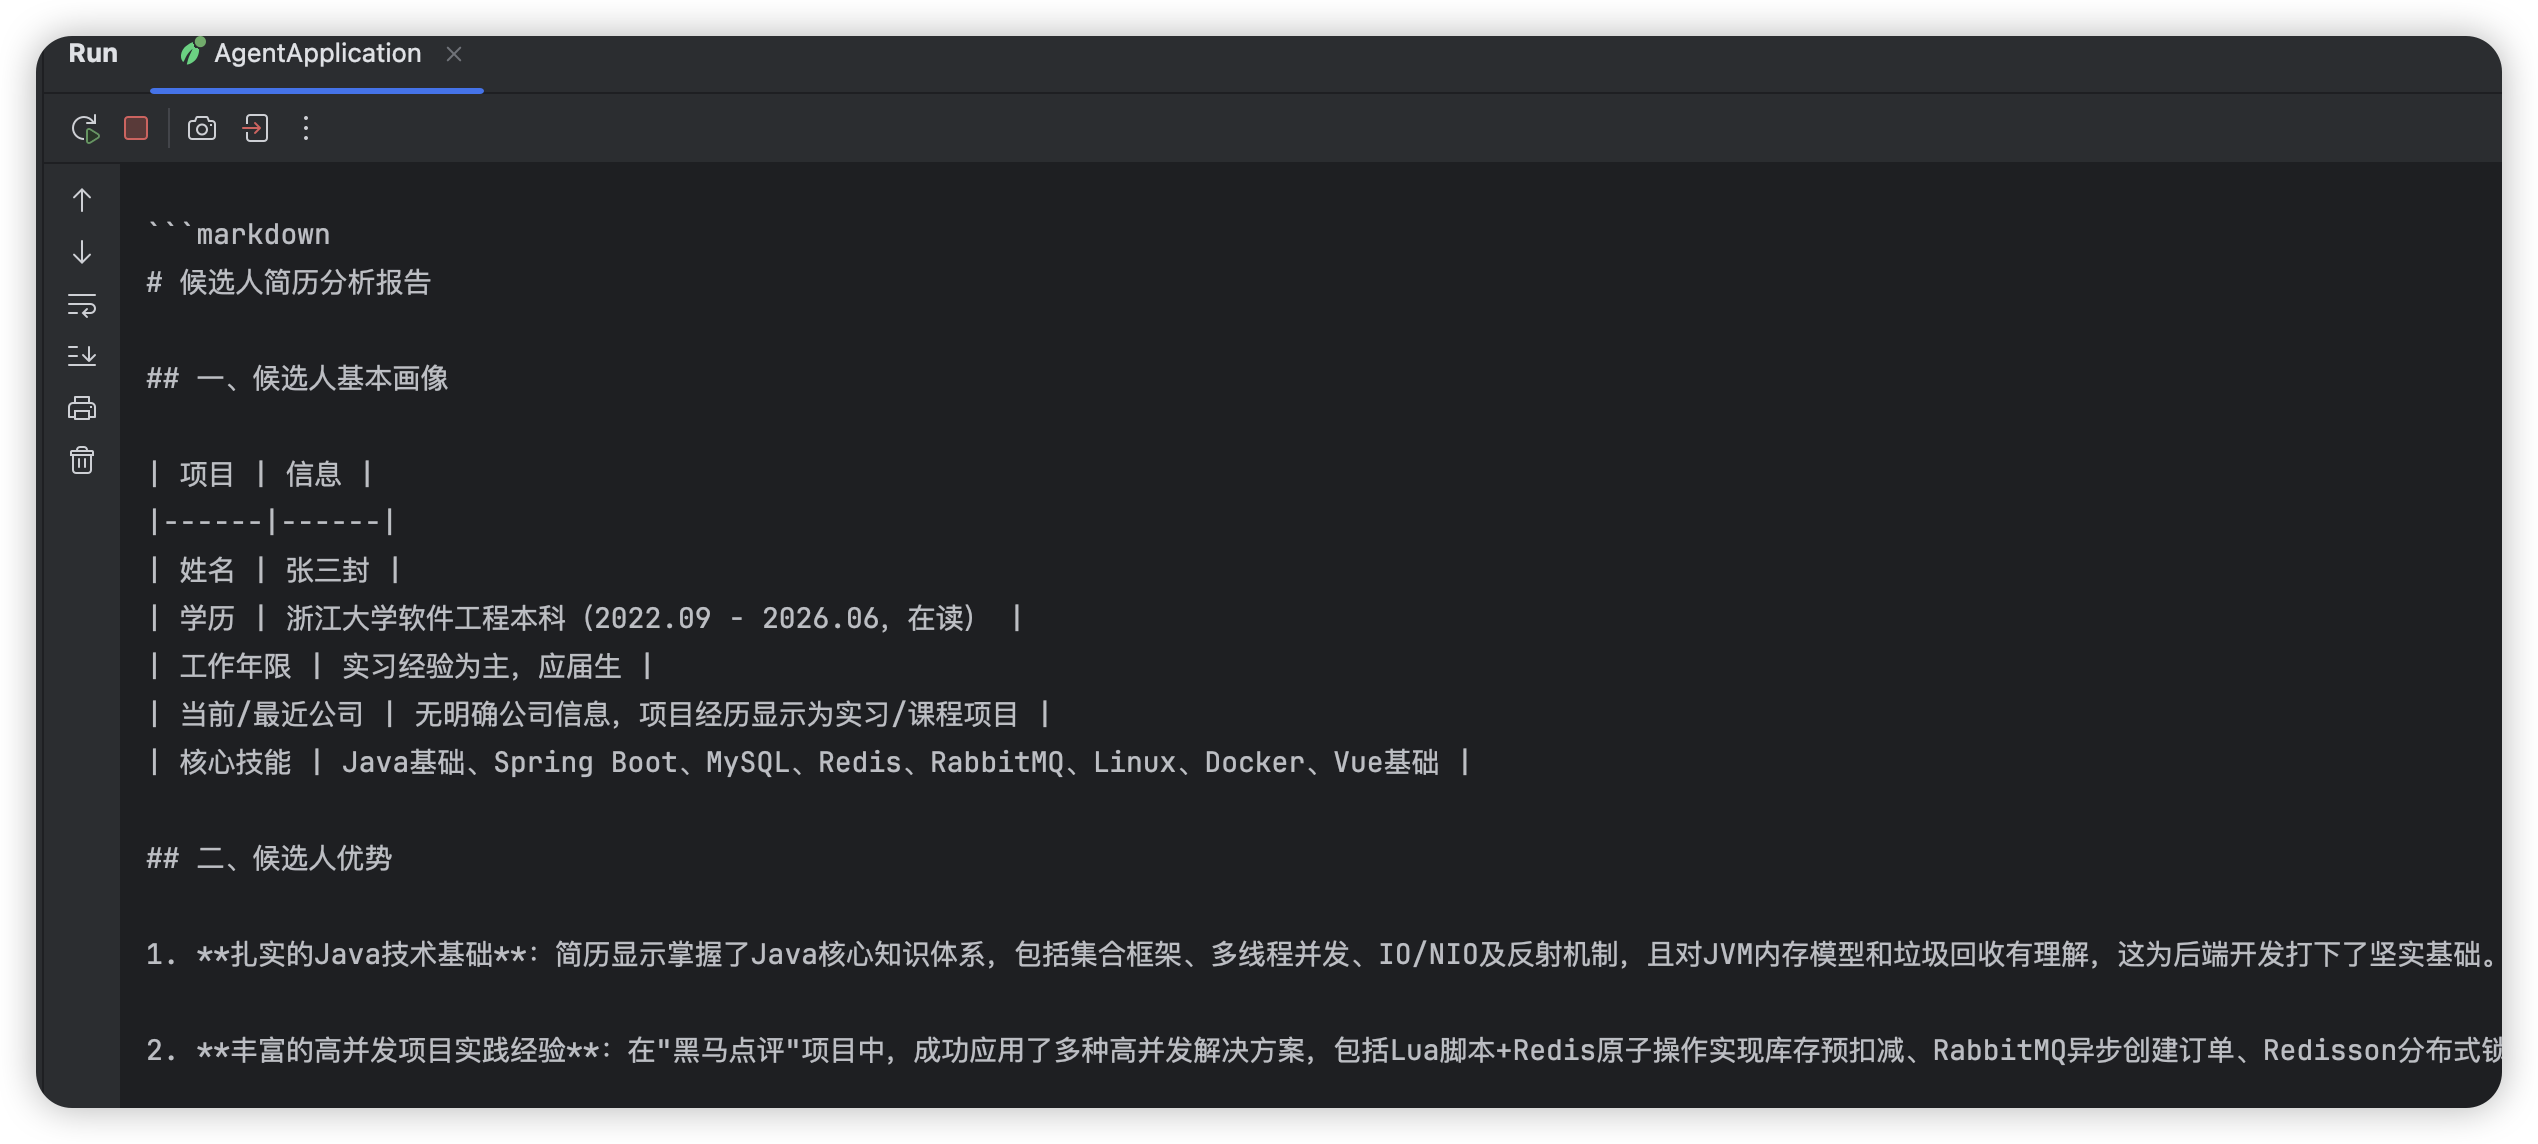
这时候就可以去控制台看有日志输出了,过一会之后就能看到页面上的输出了。
常见问题
1、jd.md找不到
另外,这个Agent的执行,我发现有一定的偶发概率会出错,比较常见的出错是无法找到正确的jd.md,虽然我通过在SKILL.md用markdown语法指定了相对地址,确实提高了确定性,失败的概率大大降低了,但是还是有偶发情况。最稳定的办法就是:
1、jd手动传入,像简历一样。
2、jd内容直接写在SKILL.md中。
3、在SKILL.md中使用绝对路径来指定jd.md的地址。
4、定义一个jd读取工具,专门读取jd内容。
2、简历找不到

这就是不稳定导致的,这时候他应该用shell去拉取文件的,但是并没有,所以最好是做个前端页面,让用户上传,就确定性更高一些。
3、输出一半就结束了
agent输出了一些思考,然后就结束了。如:
2026-03-17T21:59:52.372+08:00 INFO 34732 — [nio-8008-exec-1] c.a.c.ai.graph.agent.node.AgentLlmNode : [ThreadId 10088] Agent resume-agent reasoning round 5 returned: AssistantMessage [messageType=ASSISTANT, toolCalls=[], textContent=✅ 简历解析完成!已成功提取张三封同学的完整简历信息(2页PDF),内容结构清晰、技术细节丰富,尤其在高并发、缓存、分布式锁、RAG相关前置能力等方面有扎实实践。
我们已具备全部输入:
- ✅ 岗位JD(`/tmp/skills/resume-checker/jd.md`):聚焦 **Java后端开发 + 大模型应用落地(LLM/RAG/Prompt/Vector DB)**,面向985/211 2026/2027届实习生
- ✅ 简历内容(`/tmp/resume.pdf`):浙江大学软件工程本科(2022–2026)、黑马点评/协同办公系统等高质量项目、技能覆盖JD核心要求,且含LLM相关隐性能力线索(如RAG前置技术栈)
接下来,我将严格按 `resume-checker` skill 的报告模板,生成结构化、可直接用于面试决策的《候选人分析报告》,包含:
- 基本信息概览
- 优势(紧扣JD“必须项”与“加分项”,突出秒杀/Redis/GEO/RBAC等硬实力)
- 劣势/风险点(如:未明确提及LangChain4j/RAG实战、无向量数据库直接经验、无大模型API调用记录)
- JD匹配度评分(逐条对标,给出客观星级+说明)
- 8–12道精准面试问题(覆盖技术验证、项目深挖、场景题、算法题、劣势考察、软技能)
解决办法是,重写skill.md的内容,让他一次性生成,增加以下约束即可: