✅实战:开发一个简历评估的Skill
前面介绍了Claude Code中如何安装和使用Skill,在Qoder这个AI Coding Agent中也是支持Skills的。安装方式其实和Claude Code差不多。只不过Claude Code的安装目录是.claude下面,而qoder则是安装在.qoder下。
Qoder是一个alibaba推出的AI Coding工具,是啥我不过多介绍了。
想要创建自己的Skill,其实也不复杂,只需要按照规范编写SKILL.md就行了,但是其实你也不需要自己去编写, 完全可以借助skill-creator(https://github.com/anthropics/skills/tree/main/skills/skill-creator)这个skill来帮你创建一个自己的skill。
比如说,最近不是校招中么,我希望有这样一个简历分析的skill,帮我自动读取我上传的简历,然后分析候选人的优势和劣势,以及和我要招聘的岗位的匹配度,并且给我列出一些问题,方便我刚好的考察候选人的能力。
那么,你打开qoder,进入到Quest模式,然后把上面的需求发给他:
帮我创建一个skill,能读取我上传的简历,然后分析候选人的优势和劣势,以及和我要招聘的岗位JD的匹配度,并且给我列出一些问题,方便我刚好的考察候选人的能力。岗位的JD放在jd.md文件中,是固定的。
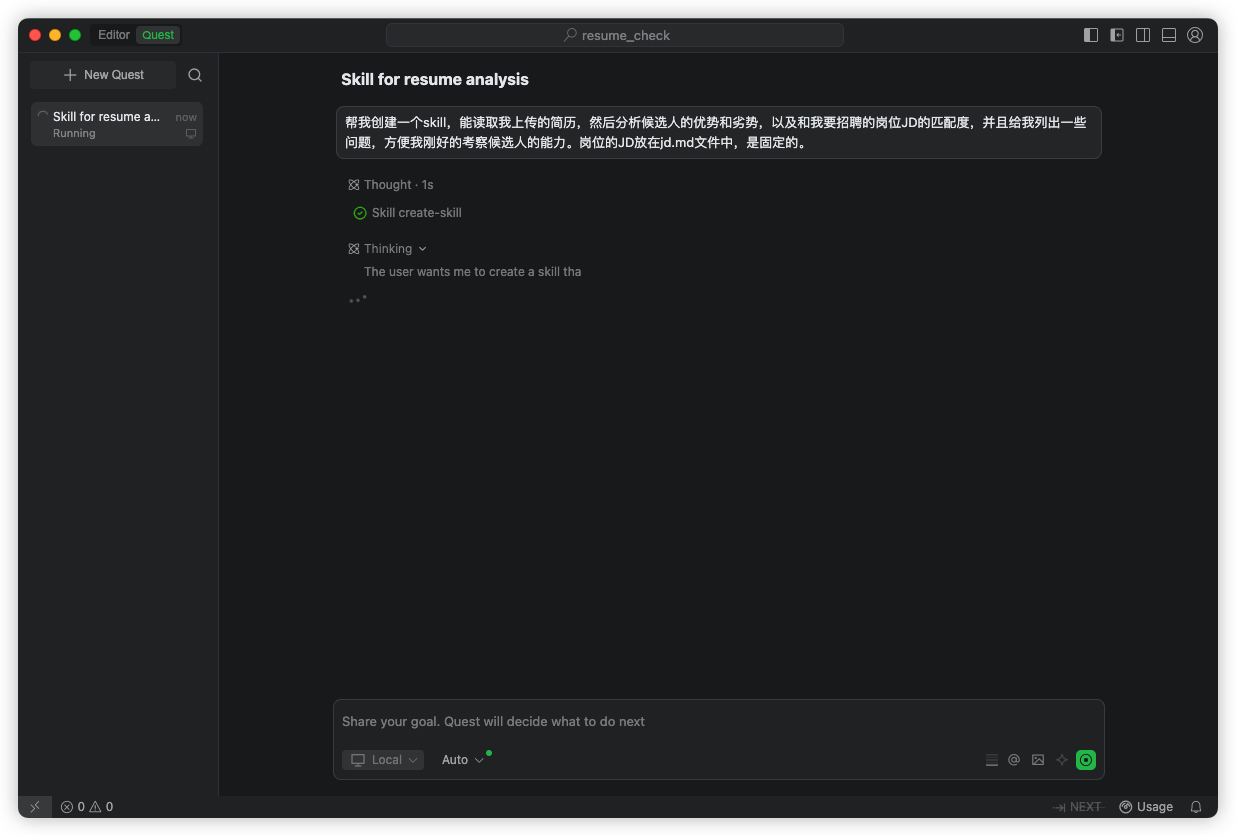
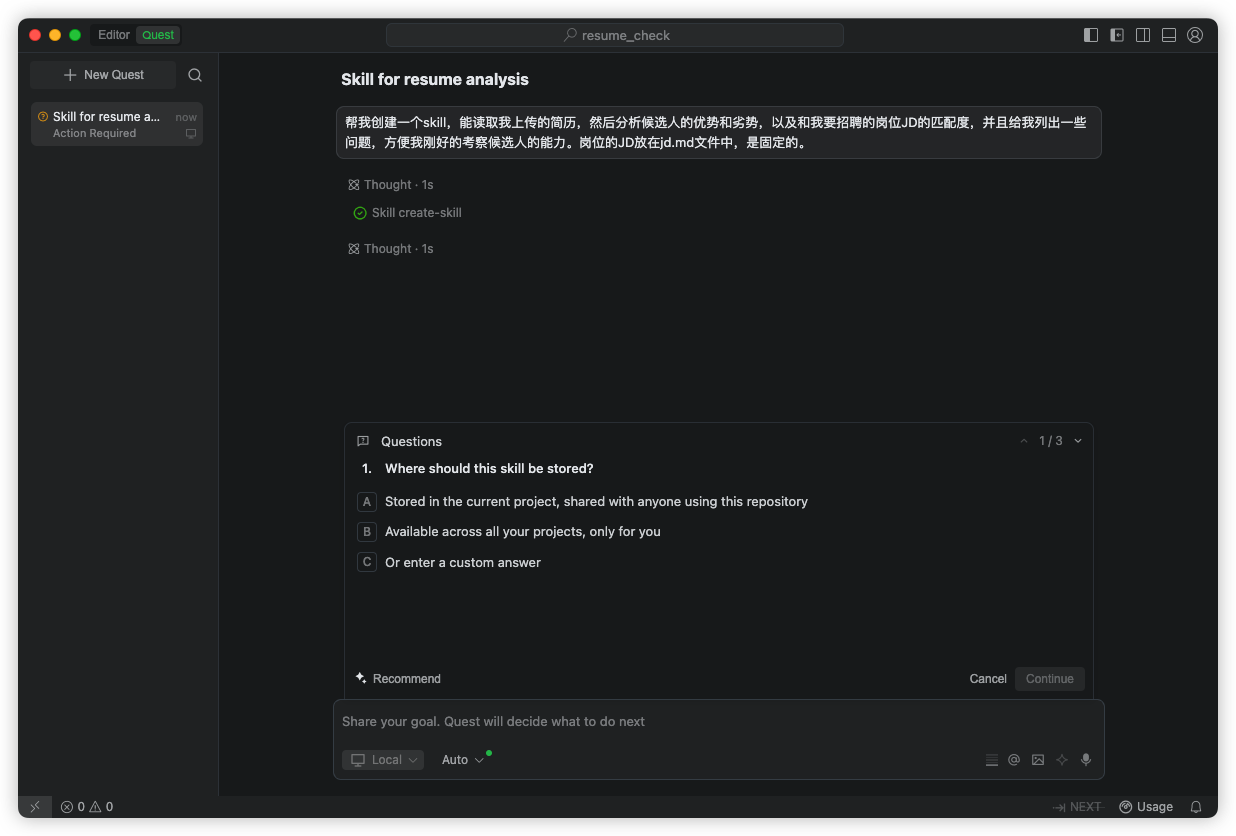
可以看到他选择了create-skill这个skill来执行这个任务。接着会几个需要我们交互的地方,有一些需求他不是很明确的,会需要做一些澄清,我们根据情况选择不同的回答给他。
他问了三个问题:
1、这个skill你想放在哪个范围用
2、简历是什么格式的
3、输出用什么语言
接着他就会生成todo了:
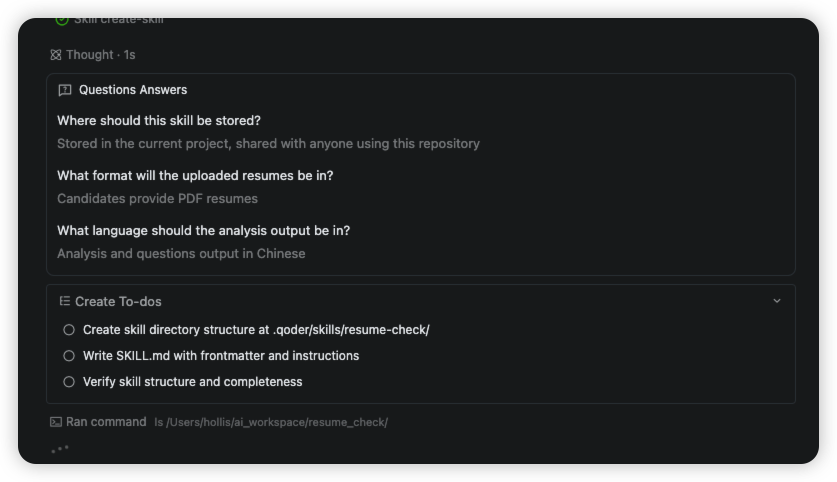
主要三个步骤,创建一个.qoder/skills/resume-check文件夹,创建并写入SKILL.md文件,检查skill的格式是否完整。经过了几秒之后,他就给我生成了一个Skill。SKILL.md内容如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
| ---name: resume-checkdescription: 分析候选人简历,评估优劣势,与岗位JD匹配度打分,并生成面试问题。当用户上传简历、提到简历分析、候选人评估、面试准备时使用此技能。Use when the user uploads a resume, mentions resume analysis, candidate evaluation, or interview preparation.---
# 简历分析与面试准备助手
## 使用前提
- 岗位JD文件固定存放在项目根目录的 `jd.md` 文件中- 候选人简历为 PDF 格式,由用户提供路径- 所有分析输出使用**中文**
## 工作流程
### 第一步:读取输入
1. 使用 Read 工具读取项目根目录下的 `jd.md` 文件,获取岗位要求2. 使用 Read 工具读取用户提供的简历 PDF 文件(Read 工具支持读取 PDF)3. 如果用户未提供简历路径,使用 AskUserQuestion 询问简历文件路径
### 第二步:解析与分析
仔细阅读简历和JD内容,从以下维度进行分析:
**候选人画像提取:**- 基本信息(姓名、学历、工作年限等)- 技术栈/核心技能- 工作经历摘要- 项目经验亮点
**优势分析:**- 与JD高度匹配的技能和经验- 突出的项目成果或业绩- 独特的竞争优势(如行业背景、技术深度等)
**劣势/风险分析:**- 与JD要求存在的差距- 简历中的疑点(如频繁跳槽、经历断层、描述模糊等)- 可能需要进一步验证的信息
### 第三步:JD 匹配度评估
逐项对照JD中的要求,评估匹配程度:
| 维度 | 评分标准 ||------|---------|| 技能匹配 | JD要求的核心技能候选人具备多少 || 经验匹配 | 工作年限、行业经验是否符合 || 项目匹配 | 过往项目与岗位工作内容的相关度 || 综合匹配 | 整体评估(加权) |
每项使用 1-5 星评分,并给出综合匹配度百分比。
### 第四步:生成面试问题
基于分析结果,生成 3 类面试问题:
1. **验证性问题**(3-5 个):针对简历中需要验证的内容,如项目细节、技术深度2. **能力考察问题**(3-5 个):针对JD核心要求,考察候选人是否真正具备所需能力3. **风险探测问题**(2-3 个):针对发现的疑点或劣势,进一步了解真实情况
每个问题附带:- **考察目的**:这个问题要验证什么- **参考回答要点**:优秀候选人应该如何回答的关键点
## 输出格式
使用以下模板输出分析结果:
```markdown# 候选人简历分析报告
## 一、候选人基本画像
| 项目 | 信息 ||------|------|| 姓名 | xxx || 学历 | xxx || 工作年限 | xxx || 当前/最近公司 | xxx || 核心技能 | xxx |
## 二、候选人优势
1. **优势1标题**:具体说明...2. **优势2标题**:具体说明......
## 三、候选人劣势/风险
1. **劣势1标题**:具体说明...2. **劣势2标题**:具体说明......
## 四、JD匹配度评估
| 维度 | 评分 | 说明 ||------|------|------|| 技能匹配 | ⭐⭐⭐⭐☆ | 具体说明 || 经验匹配 | ⭐⭐⭐☆☆ | 具体说明 || 项目匹配 | ⭐⭐⭐⭐☆ | 具体说明 || **综合匹配度** | **XX%** | 总结性说明 |
## 五、建议面试问题
### 验证性问题
**Q1: 问题内容?**- 考察目的:xxx- 参考回答要点:xxx
**Q2: 问题内容?**- 考察目的:xxx- 参考回答要点:xxx
...
### 能力考察问题
**Q1: 问题内容?**- 考察目的:xxx- 参考回答要点:xxx
...
### 风险探测问题
**Q1: 问题内容?**- 考察目的:xxx- 参考回答要点:xxx
...
## 六、总结建议
对候选人是否值得进入下一轮面试的总结性建议,以及面试中需要重点关注的方向。```
## 注意事项
- 分析要客观、基于事实,避免主观臆断- 对于简历中信息不足的部分,明确标注为"需进一步了解"- 面试问题应具有区分度,能有效考察候选人真实水平- 如果JD文件 `jd.md` 不存在或为空,提示用户先创建JD文件
|
这个SKILL.md包括了两部分,元数据中包括了名称和描述信息,说明这个SKILL是干么的,接着再指令正文中就规定了要干的事情都有哪些。
接着我们试试让他帮我分析一个简历。给他一点要求,再附上简历附件:
个人简历-
张三封.pdf(187.8 KB)
- 0%
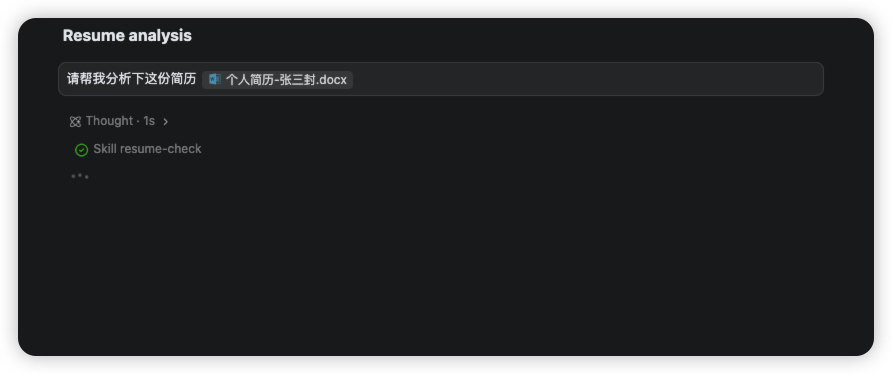
可以看到他用我的skill帮我分析简历了。因为我没有创建jd,所以他提示我了,需要给一个jd
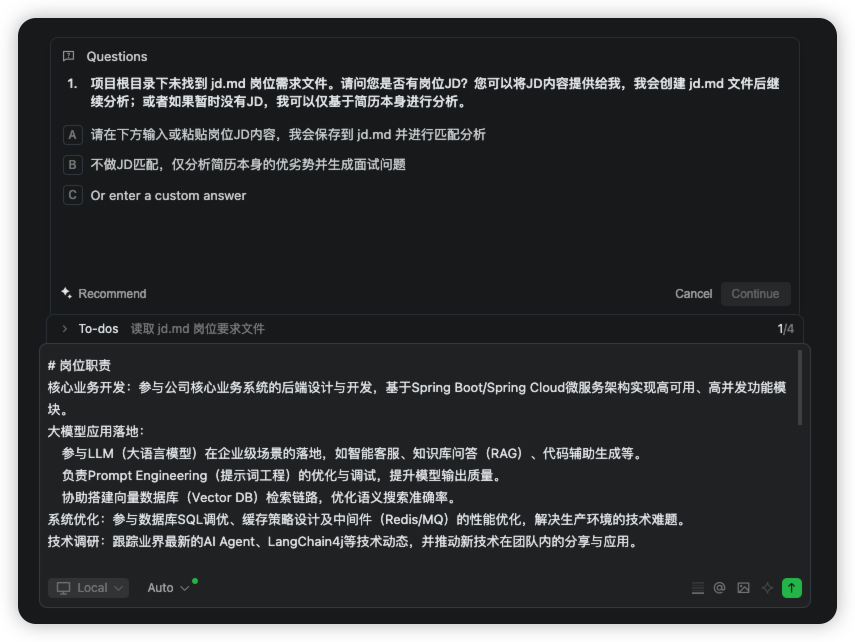
把以下内容粘贴给他:
1
2
3
4
| # 岗位职责核心业务开发:参与公司核心业务系统的后端设计与开发,基于Spring Boot/Spring Cloud微服务架构实现高可用、高并发功能模块。大模型应用落地: 参与LLM(大语言模型)在企业级场景的落地,如智能客服、知识库问答(RAG)、代码辅助生成等。 负责Prompt Engineering(提示词工程)的优化与调试,提升模型输出质量。 协助搭建向量数据库(Vector DB)检索链路,优化语义搜索准确率。系统优化:参与数据库SQL调优、缓存策略设计及中间件(Redis/MQ)的性能优化,解决生产环境的技术难题。技术调研:跟踪业界最新的AI Agent、LangChain4j等技术动态,并推动新技术在团队内的分享与应用。
# 任职要求
统招本科及以上学历,计算机、软件工程、人工智能等相关专业。必须为985或211院校在读学生(2026届/2027届毕业生优先)。基础扎实:精通Java Core,熟悉集合、多线程并发(JUC)、IO/NIO、JVM原理及调优。框架熟练:熟练掌握Spring Boot、Spring Cloud Alibaba、MyBatis-Plus等主流框架,了解其核心源码与设计模式。数据库与中间件: 精通MySQL,理解索引、事务隔离级别、锁机制,有SQL调优经验。 熟练使用Redis,了解其数据结构、持久化机制及分布式锁场景。 熟悉RabbitMQ/Kafka等消息队列,理解削峰填谷与异步解耦场景。项目经验: 必须有完整的Java后端项目经历(非简单的CRUD),能在面试中清晰阐述系统架构、技术选型理由及遇到的难点解决方案。 有GitHub开源项目贡献或技术博客者优先。
# 大模型(LLM)相关技能(加分项/核心考察点)应用开发:了解或实践过LangChain4j、Semantic Kernel等Java系大模型开发框架。RAG架构:理解检索增强生成(RAG)原理,有使用Elasticsearch、Milvus、Pgvector等向量数据库进行知识库构建的经验。模型交互:熟悉主流大模型API(如通义千问、文心一言、ChatGLM等)的调用与封装,有Function Calling(工具调用)实战经验。前沿认知:对Agent(智能体)、Prompt优化策略、模型微调(Fine-tuning)基本概念有清晰认知。
|
他会帮我把jd写入jd.md中
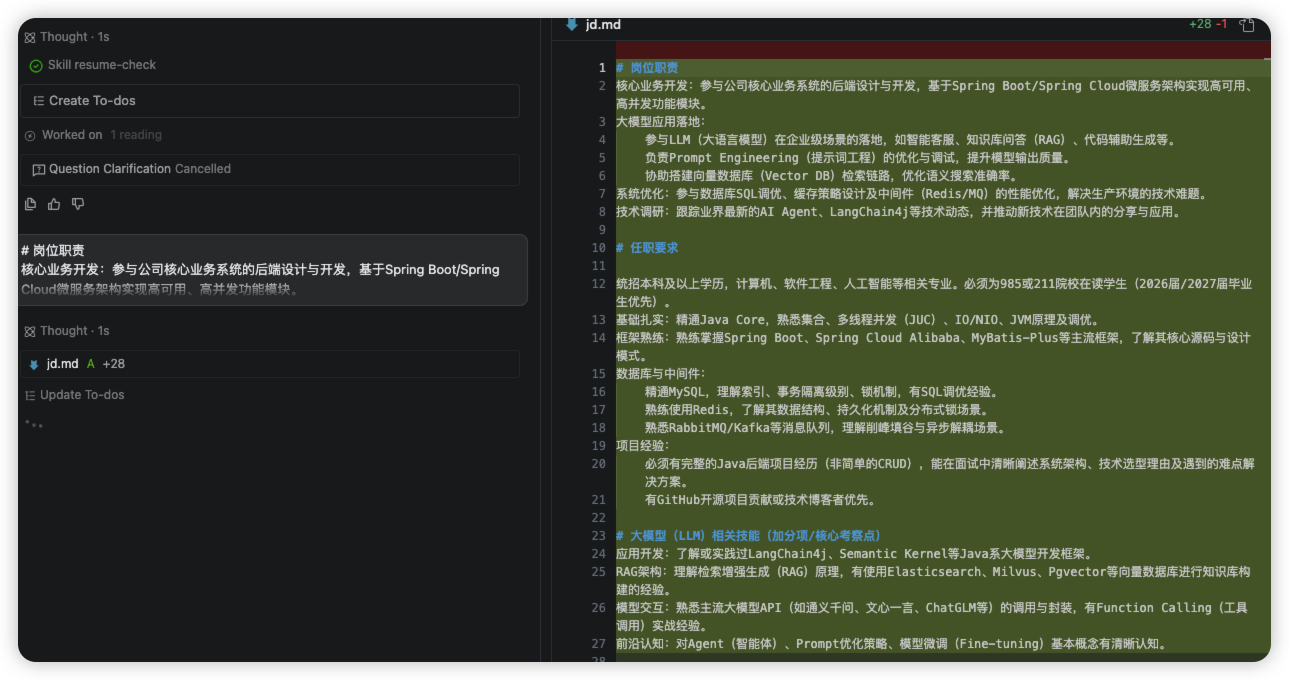
然后继续分析简历。最终能得到如下一份完整报告(你还真别说,分析的还真不错):
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
| # 候选人简历分析报告
## 一、候选人基本画像
| 项目 | 信息 ||------|------|| 姓名 | 张三封 || 学历 | 浙江大学 软件工程 本科(2022.09 - 2026.06) || 工作年限 | 应届生(2026届) || 求职意向 | Java后端开发实习生 || 核心技能 | Java、Spring Boot、Spring Cloud Alibaba、MySQL、Redis、RabbitMQ || GitHub/博客 | github.com/hollischuang || 成绩排名 | 前10% |
## 二、候选人优势
1. **院校背景优秀**:浙江大学(985)软件工程专业,完全符合JD"985或211院校"的硬性要求,且为2026届毕业生,属于优先考虑范围。成绩排名前10%,说明学习能力较强。
2. **Java基础技术栈与JD高度匹配**:简历中列出的Java基础(集合、多线程并发、IO/NIO、JVM)、框架(Spring Boot、Spring Cloud Alibaba、MyBatis-Plus)、数据库(MySQL索引/事务/锁、Redis数据结构/分布式锁)、消息队列(RabbitMQ/Kafka)均与JD要求逐项对应。
3. **项目中有高并发场景实践**:黑马点评项目涉及秒杀优化(Lua+Redis原子操作、MQ削峰)、分布式锁(Redisson)、多级缓存架构、GEO搜索优化等,与JD中"高可用、高并发功能模块"及"缓存策略设计、中间件性能优化"的要求契合。
4. **微服务实战经验**:第二个项目使用Spring Cloud Alibaba + Nacos + OpenFeign搭建微服务架构,整合Spring Security + JWT + RBAC做权限控制,集成SkyWalking + ELK做链路追踪,覆盖了JD对微服务架构能力的要求。
5. **有GitHub和技术博客**:JD明确写明"有GitHub开源项目贡献或技术博客者优先",候选人提供了GitHub地址,这是加分项。
## 三、候选人劣势/风险
1. **LLM/AI相关经验完全空白(最大短板)**:JD的核心考察点和一半岗位职责围绕大模型应用落地(RAG、Prompt Engineering、向量数据库、LangChain4j、AI Agent等),但简历中**没有任何AI/LLM相关的技能或项目经验**。这是与岗位匹配的最大缺口。
2. **项目疑似培训课程作业**:"黑马点评"是黑马程序员(知名Java培训机构)的经典课程项目,项目描述中的技术方案(Lua脚本+Redis预扣减、Redisson分布式锁、逻辑过期+互斥锁等)与该课程内容高度吻合。面试中需要重点验证候选人是否真正理解这些方案,还是仅仅跟着教程实现。
3. **缺乏独立项目或实际业务经验**:两个项目均为学习型项目,没有企业实习经历或独立开发的项目。对于一个成绩前10%的浙大学生来说,缺少实习经历略显单薄。
4. **技术描述存在"堆砌"倾向**:简历中出现较多量化数据(如"2000+ QPS"、"500ms降至20ms"、"节省90%存储空间"),但在没有实际线上环境验证的情况下,这些数据的可信度需要质疑——学习项目通常不具备真实的压测环境和用户流量。
5. **框架了解偏"使用层面"**:JD要求"了解核心源码与设计模式",但简历仅描述了框架的使用,未体现对源码的理解深度。
## 四、JD匹配度评估
| 维度 | 评分 | 说明 ||------|------|------|| 技能匹配 | ⭐⭐⭐⭐☆ | Java基础、框架、数据库、中间件与JD传统后端要求高度匹配;但LLM相关技能完全缺失 || 经验匹配 | ⭐⭐⭐☆☆ | 2026届浙大本科符合学历要求;但无实习经历,项目均为学习型,缺乏实际业务经验 || 项目匹配 | ⭐⭐⭐☆☆ | 项目覆盖了高并发、微服务等场景,但疑似培训课程项目,且完全没有LLM/AI应用项目 || LLM技能匹配 | ⭐☆☆☆☆ | JD核心考察的RAG、向量数据库、Prompt Engineering、LangChain4j、Agent等全部缺失 || **综合匹配度** | **55%** | 传统Java后端基础扎实且匹配度高,但岗位对LLM能力有明确要求(既是加分项也是核心考察点),该维度完全空白拉低了整体匹配度 |
## 五、建议面试问题
### 验证性问题
**Q1: 黑马点评项目中,你提到用"Lua脚本+Redis原子操作"实现库存预扣减并支撑2000+ QPS,请详细描述一下这个Lua脚本的具体逻辑?2000+ QPS这个数据是如何测试得出的?用的什么压测工具和环境?**- 考察目的:验证候选人是否真正理解秒杀方案的实现细节,还是仅仅照搬培训课程代码;验证性能数据的真实性- 参考回答要点:能说清Lua脚本中判断库存、判断一人一单、扣减库存的原子操作流程;能说出压测工具(如JMeter/wrk)、测试环境配置、并发线程数等具体参数;诚实说明是本地测试还是线上数据
**Q2: 你的多级缓存架构中,"逻辑过期+互斥锁"具体是怎么配合工作的?如果互斥锁获取失败,返回的是什么数据?这种方案和直接设置TTL过期有什么区别?**- 考察目的:验证对缓存一致性方案的深入理解,区分"背方案"和"真理解"- 参考回答要点:能解释逻辑过期不设置真实TTL、由后台线程异步重建缓存、锁失败返回旧数据的完整流程;能对比分析与直接TTL的优劣(可用性 vs 一致性权衡)
**Q3: 企业协同办公系统中,你使用Spring Security + JWT实现无状态认证,那JWT的token过期后如何处理?如果需要强制让某个用户的token失效(如踢人下线),在无状态架构下你会怎么做?**- 考察目的:验证候选人对JWT机制的理解是否超越了"会用"的层面,能否思考实际场景中的问题- 参考回答要点:了解JWT无状态的局限性;能提出黑名单机制(Redis存储已失效token)、短过期时间+Refresh Token等方案;能分析各方案的优劣
**Q4: 你提到使用Redis GEO实现附近商户搜索,响应从500ms降至20ms。请问Redis GEO底层用的什么数据结构?GeoHash的精度是怎么控制的?如果商户数据量从1万增长到100万,这个方案还能保持20ms的响应吗?**- 考察目的:验证候选人对Redis GEO的理解深度以及面对规模增长时的思考能力- 参考回答要点:知道底层是Sorted Set + GeoHash编码;理解GeoHash精度与位数的关系;对大数据量场景能提出分片、限制搜索范围等优化思路
### 能力考察问题
**Q1: 假设现在要你从零设计一个简单的RAG(检索增强生成)系统,用于公司内部知识库问答。请描述你的技术方案,包括数据处理、向量化、检索、生成的完整链路。**- 考察目的:考察候选人对LLM应用核心架构的认知(JD核心要求),评估其学习潜力和技术视野- 参考回答要点:能描述文档分块(Chunking)、Embedding向量化、向量数据库存储与检索、Prompt组装、LLM生成的基本流程;即使没有实操经验,能展示出清晰的技术思路和自学能力即为加分
**Q2: 在你的秒杀系统中,Redis和数据库之间的数据一致性是怎么保证的?如果RabbitMQ消费失败了怎么办?消息重复消费怎么处理?**- 考察目的:考察候选人对分布式系统数据一致性问题的理解深度- 参考回答要点:能描述最终一致性方案;了解消息确认机制(ACK)、死信队列、重试策略;能提出幂等性方案(如唯一订单号)解决重复消费
**Q3: 你了解JVM垃圾回收机制,请对比一下CMS和G1收集器的区别?在什么场景下你会选择G1而不是CMS?如果线上出现频繁Full GC,你的排查思路是什么?**- 考察目的:JD要求"精通JVM原理及调优",考察候选人是否具备JVM调优的实战思路- 参考回答要点:能从内存分区模型、回收算法、停顿时间目标等维度对比CMS和G1;Full GC排查能提到查看GC日志、分析堆dump、排查内存泄漏、调整JVM参数等步骤
**Q4: 如果让你用Java调用一个大模型API(如通义千问),实现一个简单的多轮对话功能,你会怎么设计?需要考虑哪些问题?**- 考察目的:评估候选人对LLM API交互的基本认知和工程化思维- 参考回答要点:能考虑到上下文管理(历史消息拼接)、Token限制与截断策略、流式响应(SSE)、异常处理与重试、API Key安全存储等问题
### 风险探测问题
**Q1: 你的两个项目(黑马点评和协同办公系统)是自己从零搭建的,还是跟着课程/教程做的?在做这些项目的过程中,你遇到的最大的一个"课程里没教、需要自己解决"的问题是什么?**- 考察目的:直接探测项目的真实性和候选人的独立解决问题能力;培训课程项目本身不是问题,关键是候选人是否有超出课程的独立思考- 参考回答要点:诚实回答项目来源加分;能说出具体的、非典型的问题和自己的解决过程说明有真实动手经验;如果只能复述课程内容则需要警惕
**Q2: JD中大模型相关的技能是核心考察点,我注意到你的简历中没有这方面的经验。你对大模型应用开发(如RAG、Agent、Prompt Engineering)了解多少?有没有做过相关的自学或尝试?**- 考察目的:直接评估候选人对岗位核心要求的认知和学习意愿,判断其是否有潜力快速补齐这块短板- 参考回答要点:能展示出对LLM领域的关注和基本认知(即使没实操);有自学计划或已经开始学习的为佳;如果完全不了解,则岗位匹配风险较高
**Q3: 你简历上写的成绩排名前10%,但项目经历都是学习项目,为什么没有争取实习机会?大学期间除了课程学习和这两个项目,还做了哪些与技术相关的事情?**- 考察目的:了解候选人的时间分配和主动性,评估其技术热情是否仅停留在"完成课程"层面- 参考回答要点:能给出合理解释(如科研、竞赛、社团等);有额外的技术探索经历(如开源贡献、技术博客内容、竞赛等)说明技术热情较高
## 六、总结建议
**建议:可以进入面试,但需重点考察两个维度。**
**候选人的优势面**:浙大985背景 + 前10%成绩 + 完整的Java后端技术栈,基本功在实习生候选人中属于中上水平。传统后端技能(Spring Boot/Cloud、MySQL、Redis、MQ)与JD要求匹配度较高。
**核心风险点**:1. **LLM能力缺口是最大障碍**。该岗位一半职责围绕大模型应用落地,且LLM技能被列为"核心考察点"。候选人在此维度完全空白,面试中需要判断其学习意愿和潜力能否弥补这个缺口。2. **项目真实性存疑**。"黑马点评"是广为人知的培训课程项目,面试中需通过深挖细节来判断候选人的真实技术理解深度,而非简单的"背八股文"能力。
**面试重点方向**:- 花30%时间深挖项目细节,验证技术理解深度(而非背诵能力)- 花40%时间考察LLM相关认知和学习潜力,这是决定是否录用的关键- 花30%时间考察Java基础和系统设计思维,评估其成长天花板
|
以上就是一个简单的SKILL的实现过程了,因为有了create-skill这个skill,创建Skill其实就非常简单了。SKILL.md的内容,针对其中的内容,你可以做你自己的修改。比如你如果想要让他最终给你输出的是一个网页而不是仅仅是一个md的话,也可以让他给你改,直接改SKILL.md或者是直接和qoder对话都可以。
有了上面的skill之后,你可以把它内容复制过去,放到你自己的qoder、cc、cursor等中,帮你分析分析你的简历。或者是你也可以自己构造一个简历优化的Skill。
