
15-05 AgentScope Java特性:智能上下文压缩
✅AgentScope Java特性:智能上下文压缩
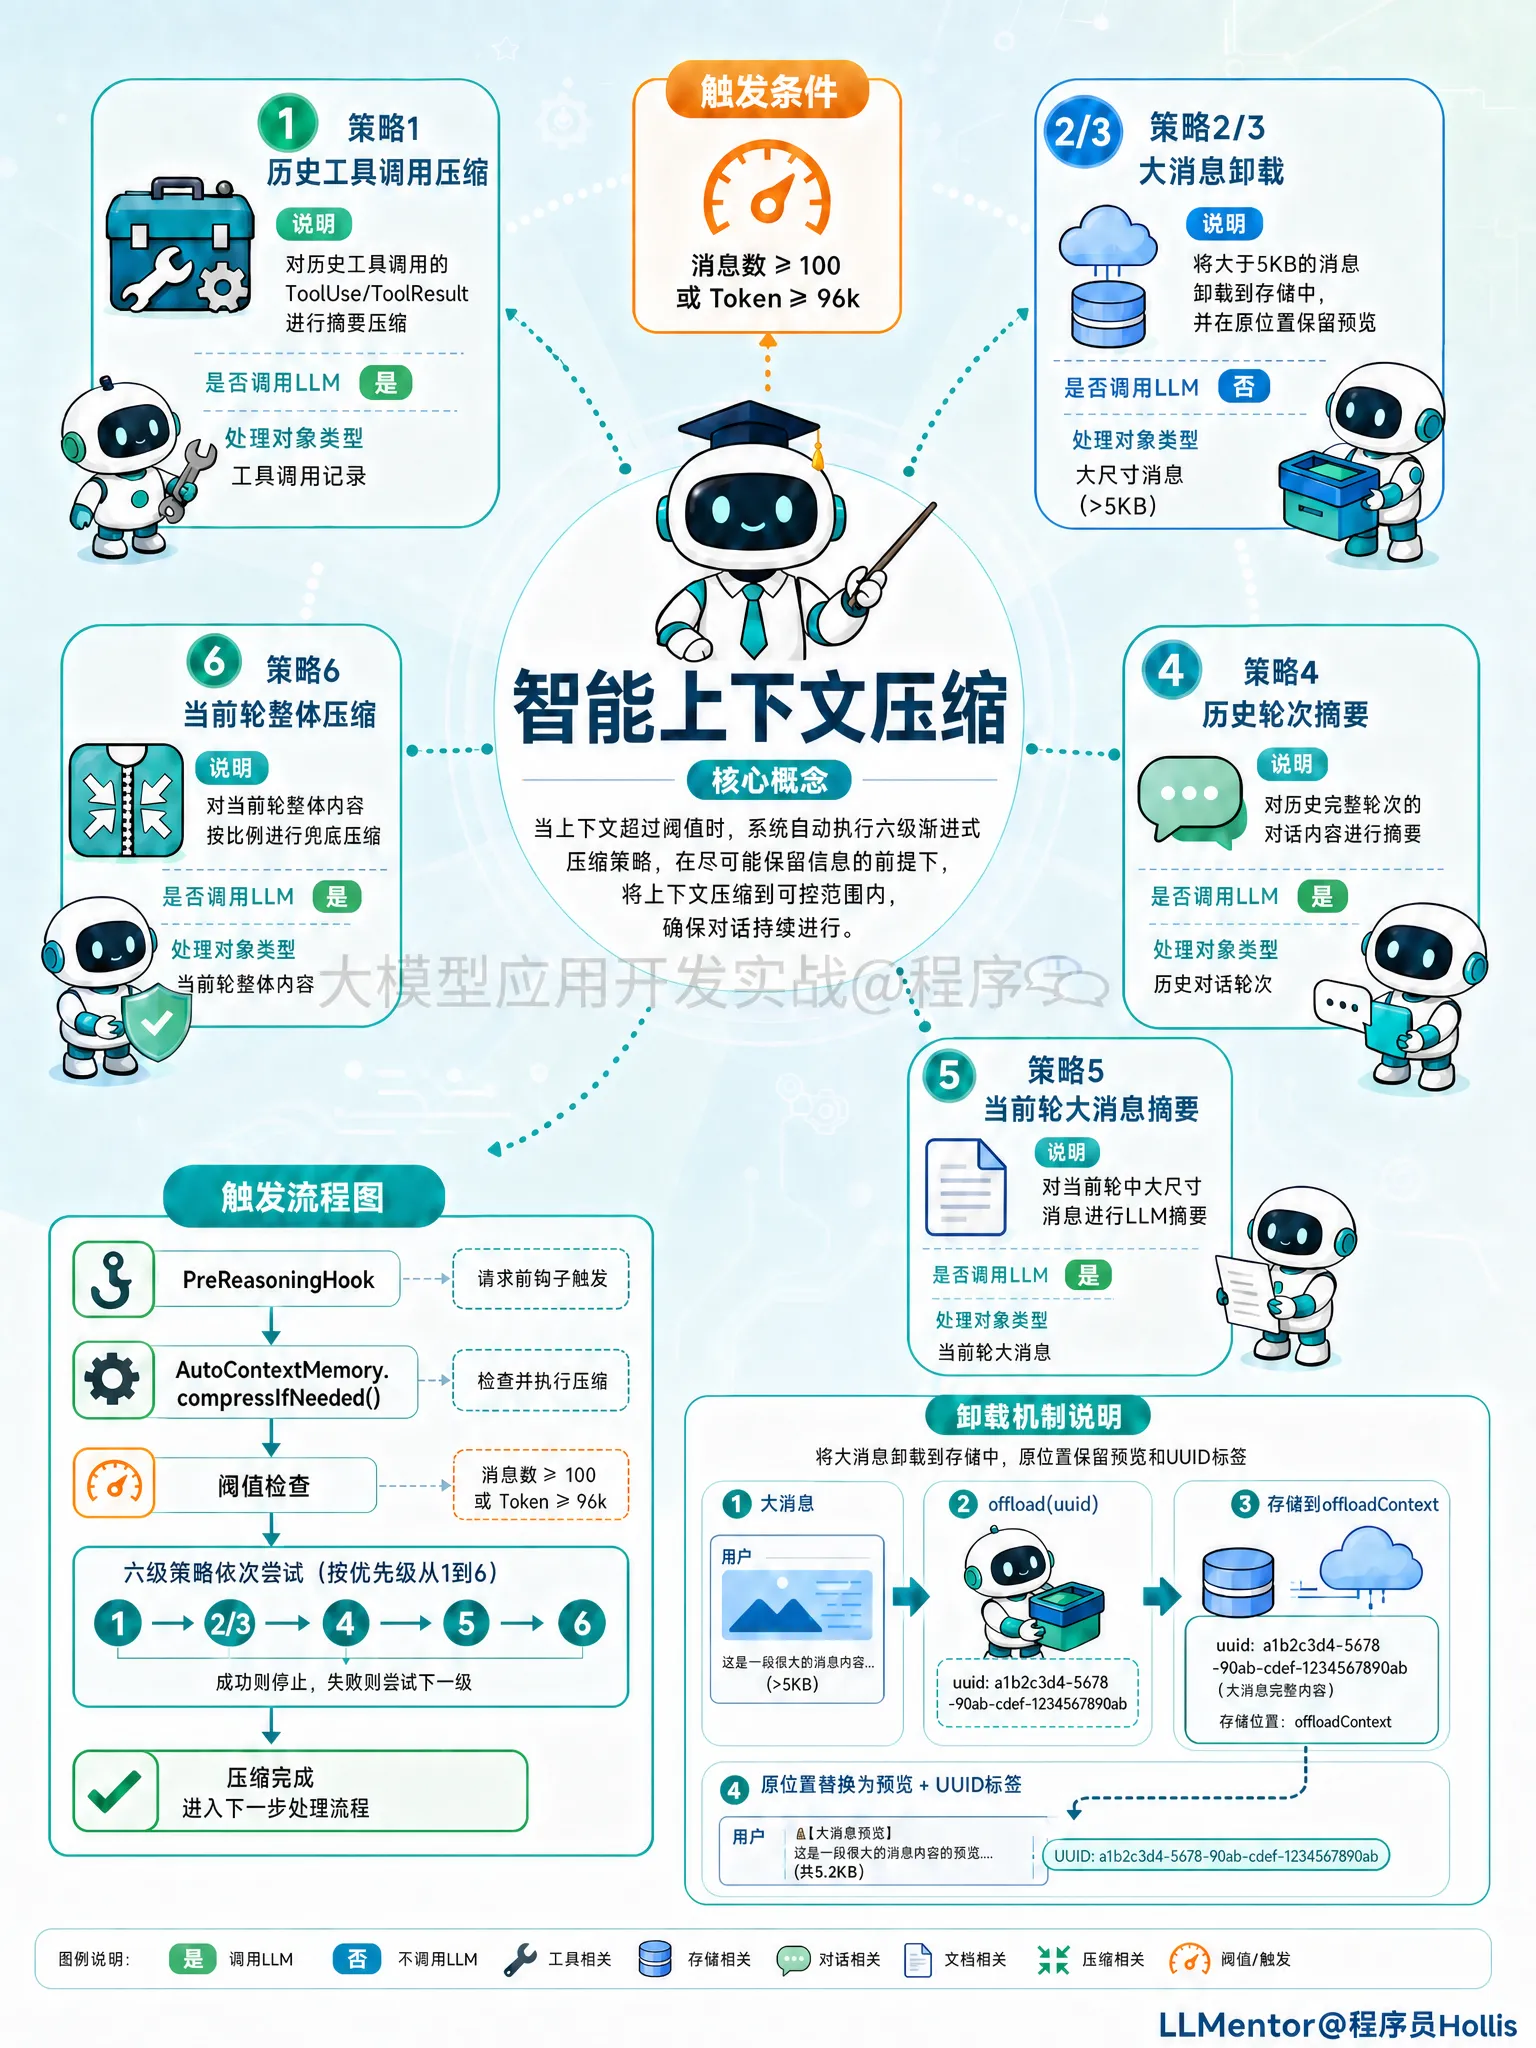
ASJ中在多轮对话、持久化对话以及长期记忆之外,还提供了个内置的上下文自动管理的机制,能实现自动的上下文压缩和卸载。用来解决长会话或者多轮 ReAct 工具调用中出现的token 爆炸、上下文窗口溢出问题。
这部分能力靠AutoContextMemory实现的,它实现了 Memory 接口,通过六级渐进式压缩策略,在对话长度逼近模型上下文窗口时自动”瘦身”,同时把原始内容卸载到外部存储(可通过 ID 重新加载)。
传统做法只能”截断”或”全量摘要”,AutoContextMemory 则按场景智能选择”压什么”和”怎么压”。
压缩触发条件:
1 | // 消息数量超过 msgThreshold,默认 100 条boolean msgCountReached = messages.size() >= msgThreshold; // Token 数量超过 模型最大上下文 × tokenRatio ,默认 128k * 0.75 = 96kboolean tokenCountReached = tokens >= maxToken * tokenRatio; |
以上两个任一条件满足就触发。
六级渐进式压缩策略
在 Agent 长对话场景下,token 膨胀来自不同源头:工具调用日志、用户上传的大文档、历史对话轮次、当前轮的临时输出……每种内容的”压缩性价比”完全不同。如果只用一种策略,要么压不够(只压一种),要么压过头(一刀切全摘要)。
AutoContextMemory 的设计哲学是:先压”代价低、收益高”的,再压”代价高、收益不确定”的。具体优先级排序考虑两个维度:
第一个维度是是否调用 LLM。调 LLM 摘要要花钱、要等待,是昂贵操作。能用纯字符串操作(卸载+预览替换)解决的,就绝不调 LLM。
第二个维度是是否影响当前对话进行中的内容。最近的对话是最敏感的——用户刚说的话、Agent 正在思考的工具调用,一旦动了就可能让模型”失忆”。所以历史内容比当前内容更优先被压。
把这两个维度交叉,就得到了六级策略的顺序:
从”压历史 + 不调 LLM”开始(策略 2/3 大消息卸载),到”压历史 + 调 LLM”(策略 1/4 工具序列、历史轮摘要),最后到”压当前 + 调 LLM”(策略 5/6 当前轮处理)。
但实际代码里还有个策略 1 排在最前,因为工具调用是 ReAct 循环里最常见的 token 大户,专门优化。
六级渐进式压缩策略,按”代价从低到高”顺序尝试,只要有一个生效就停止(不会同时跑多个)。
1 | PreReasoningHook │ ▼AutoContextMemory.compressIfNeeded() │ ├─ 阈值检查(msgCount/token) │ ├─ 策略 1: extractPrevToolMsgsForCompress() │ ↓ 找到区间 │ summaryToolsMessages() │ ↓ token≥5000 │ offload(uuid) + compressToolsInvocation() ──→ LLM │ ↓ 替换 │ [N条工具消息] → [1条摘要+UUID标签] │ ├─ 策略 2/3: offloadingLargePayload(lastKeep=true|false) │ ↓ 倒序遍历 │ offload(uuid) → 替换为预览+UUID标签 (无 LLM) │ ├─ 策略 4: summaryPreviousRoundMessages() │ ↓ 收集所有 (user,assistant) 对 │ 倒序处理 → offload + summaryPreviousRoundConversation() ──→ LLM │ [user...assistant整轮] → [user, 1条摘要] │ ├─ 策略 5: summaryCurrentRoundLargeMessages() │ ↓ 倒序找当前轮大消息 │ offload + generateLargeMessageSummary() ──→ LLM │ 保留 ToolUse/ToolResult 结构,仅替换文本块 │ └─ 策略 6: summaryCurrentRoundMessages() (兜底) ↓ 整个当前轮(user 之后) offload + generateCurrentRoundSummaryFromMessages() ──→ LLM 带 30% 字符数硬约束 |
第一级:历史工具调用压缩
ReAct Agent 的工作模式是”思考→调工具→看结果→再思考→再调工具”,每次工具调用会产生两条消息(ToolUseBlock 描述调用、ToolResultBlock 装结果)。一个完成的任务下来,工具消息可能占整个上下文的一半甚至更多。而且工具结果往往是”过程性”的——比如 SQL 查询结果、网页抓取内容——一旦 Agent 已经基于它做了下一步动作,原始结果就可以摘要成”我之前查到了 XX 信息”。
所以工具消息是压缩收益最高的目标。
1 | private boolean summaryToolsMessages(List<Msg> rawMessages, Pair<Integer, Integer> toolMsgIndices) { |
1 | private Msg compressToolsInvocation(List<Msg> messages, String offloadUUid) { |
压缩实际用到的提示词:
1 | “你是一位专业的内容压缩专家。你的任务是智能地压缩并总结以下工具调用历史记录:必须保留:工具名称、精确的参数(含具体值),以及对输出结果的简明事实性总结。针对同一工具的重复调用:• 将完全相同的调用(参数相同、结果相同)合并为一条记录,并注明调用频次。• 仅列出导致不同结果的不同参数组合。• 如果行为未发生改变,请省略非必要的可变参数(例如时间戳、请求 ID 等)。如果工具的名称或输出结果暗示了副作用(例如包含 'write'、'update'、'delete'、'create',或返回了类似 'written' 的确认信息),则应将其视为写入/修改操作。对于此类操作,必须保留关键细节:文件路径、数据键名、内容片段、状态变更以及成功/错误指示。输出必须是纯文本格式——严禁使用 Markdown、JSON、项目符号、标题或任何元评论。如果发现任何工具的输出被截断或损坏,请加上 '[TRUNCATED]' 标记。” |
通过这个提示词,把冗长的工具调用日志“瘦身”。既要保证关键信息(参数、结果、修改了什么文件)不丢,又要自动合并重复的废话,最后还得老老实实输出纯文本,不能加任何花里胡哨的排版。
第二/三级:大消息卸载
在第二级和第三季的压缩机制中,会针对大消息做卸载。大消息指的是超过 largePayloadThreshold的消息内容(默认 5KB),
5KB 这个数字的含义大约是:一个长篇网页正文、一个完整的 SQL 查询结果集、一段几千字的论文摘录、一张图的 base64 编码——这些内容的特点是”信息密度低且查阅频率低”,不需要实时存在于上下文里,按需 reload 即可。
所谓卸载。是这样的流程:取出消息的文本内容,比较长度是否超过阈值。超过的话:
第一步,生成一个新 UUID,把原始消息整条放进 offloadContext。
第二步,截取前 offloadSinglePreview 个字符(默认 200)作为预览,再加省略号。注意这个预览不是简单截前 200 字,而是构造成”前 200 字内容 + 换行 + <context_offload uuid=”xxx”/> 标签”的形式。
第三步,构造一条新的替代消息,role 和 name 都和原消息相同(保持角色身份),content 只放上面构造好的预览文本,metadata 里写入压缩元数据(包括 offloaduuid)。
第四步,用 rawMessages.set(i, replacementMsg) 直接原位替换。
第五步,记录压缩事件(事件类型为 LARGE_MESSAGE_OFFLOAD_WITH_PROTECTION 或 LARGE_MESSAGE_OFFLOAD,区分策略 2/3)。
1 | ┌─────────────────────────────┐│ 大消息(>5KB) ││ "..(海量原文)..." │└──────────┬──────────────────┘ │ offload(uuid, [msg]) ▼┌─────────────────────────────┐│ offloadContext ││ {uuid_xxx -> [原始 Msg]} │└─────────────────────────────┘ │ │ 原位置替换为 ↓ ▼┌─────────────────────────────┐│ 替代消息(200 字预览) ││ "..(前200字)..." ││ <context_offload uuid=xxx/> │└─────────────────────────────┘ |
策略 2 和策略 3 用的是同一个方法 offloadingLargePayload,区别只是 lastKeep 参数(是否保护最近的消息不被处理)。这种”先保守后激进”的设计很常见——能用温和方式解决就不要用激进方式。
策略 2 的”保护”含义是:在卸载大消息时,最近的 lastKeep 条(默认 50)一定不动。这样即便大消息恰好出现在最近,也优先保留以维持对话连贯性。
如果策略 2 找到了可卸载的内容(即”既是大消息、又不在最近 50 条里”),就生效返回;
如果策略 2 因为”所有大消息都在最近 50 条里”或”根本没有大消息超出 lastKeep 范围”而无功而返,就到策略 3。
策略3的lastKeep 参数变成 false。这导致搜索范围扩大到”从开头到最新 final assistant”——也就是说,最近 50 条里的大消息现在也成了候选。
但即便如此,仍然不会动 final assistant 之后的内容(即当前正在进行的轮次),所以”破坏当前对话”的风险还是很低。
1 | boolean hasOffloadedLastKeep = offloadingLargePayload(currentContextMessages, true); // 策略2if (hasOffloadedLastKeep) { replaceWorkingMessage(...); return true; } |
1 | private boolean offloadingLargePayload(List<Msg> rawMessages, boolean lastKeep) { |
策略 2/3 完全不调 LLM,只做字符串截取和 Map 写入操作。一次执行可以处理多条消息(倒序遍历,每条都判断阈值)。即使在 10 万条消息的极端场景下,策略 2/3 也是毫秒级完成。这就是它们排在 LLM 类策略前面的原因——便宜、快、可靠。
被卸载的内容,如果后续agent还是要看的话,也可以通过这个uuid来查询(保存在<context_offload uuid=”xxx-yyy”/> 标记中):
1 | LLM: 我需要看 uuid=xxx-yyy 的完整内容 ↓ 调用工具context_offload(uuid="xxx-yyy") ↓ 返回ContextOffloadTool.reload(uuid) → memory.reload(uuid) → 原始 Msg 列表 |
第四级:历史轮次摘要
前面三种策略,要么是针对工具的,要么是针对大消息的,而到了第四轮,开始针对历史短对话了。主要应对那种对话轮次多导致的上下文膨胀问题。
这个阶段的实现是,先扫描整个 working memory,找最近一条 final assistant response 作为”当前轮”的标志——它和它之后的消息绝对不动。
然后从开头扫到这个 latest assistant 之前,识别所有 (user, assistant) 配对:遇到 user 消息就记下索引,再往后第一个 final assistant response 形成一个配对。配对的判断条件是”两者之间至少有一条消息”——如果 user 之后立刻就是 assistant(直接回复,没工具调用),这种轮次本身就很短,没必要压缩。
扫完之后得到一个 pair 列表,每个 pair 是 (userIndex, assistantIndex)。
比如:
1 | user[1]: "帮我订机票"assistant[2]: 调用 search_flights 工具tool[3]: 返回 50 条航班assistant[4]: "我推荐这 3 条..."(final response) |
然后会调用 summaryPreviousRoundConversation 让 LLM 生成摘要。这个 prompt 与策略 1 不同,要求模型”把整轮对话压缩成一段总结”,重点是 user 提了什么需求、Agent 给了什么结论。
以上对话压缩完之后:
1 | user[1]: "帮我订机票"assistant[摘要]: "用户询问机票预订,我搜索后推荐了 3 条航班(CA1234, MU5678, 9C7890)。详情见 uuid=abc-123。" |
被卸载的 [2][3][4] 三条全部存进 offloadContext,可通过 UUID 拉回。
本轮用到的默认压缩提示词:
1 | “你是专为自主智能体(Autonomous Agents)设计的对话压缩专家。你的任务是重写上一轮助手的最终回复,将其改写为一个自包含、简洁的回复,并将该轮次中获取的所有关键事实融入其中——且绝不能提及任何工具、函数或内部执行步骤。输入内容将包括:用户的原始提问、助手的原始回复,以及用于生成该回复的任何工具执行结果。你的输出将替换对话历史中的原始助手消息,从而为未来的上下文构建一个干净的‘用户 -> 助手’对话对。处理准则:绝对不要提及工具、函数、API 调用或执行步骤(例如,避免使用‘我调用了……’、‘系统返回了……’、‘在运行 X 之后……’等表述)。相反地,请将所有发现直接陈述为助手现在已掌握的事实性知识。保留工具结果中的关键事实,特别是:• 文件路径及其内容、变更或创建情况(例如:‘/etc/app.conf 设置了 port=8080’)。• 具有诊断价值的精确错误信息(例如:‘Permission denied (errno 13)’、‘timeout after 30s’)。• ID、URL、端口号、状态码、配置值和数据键名。• 写入/修改操作的执行结果(例如:‘已将维护标志写入 /tmp/status’、‘已更新数据库中 user_id=789 的邮箱’)。• 服务状态或进程信息(例如:‘auth-service 已停止’、‘PID=4567’)。如果执行了某项操作(例如:写入了文件、重启了服务),请明确说明更改了什么以及更改的位置。如果某项操作失败或未完成,请说明具体的限制条件(例如:‘无法重启:权限被拒绝’)。合并冗余信息;省略那些没有任何可操作细节的通用成功提示。使用清晰、信息量丰富的语言——避免使用诸如‘根据日志显示……’或‘观察到……’等元描述短语。输出必须是纯文本格式:严禁使用 Markdown、项目符号、JSON、XML 或章节标题。” |
它要求 AI 把上一轮通过查资料、跑代码得到的结果,直接揉进最终回复里,并且彻底抹除所有“我调用了工具”、“系统返回了”这种暴露 AI 内部工作机制的痕迹。同时,它强调必须保留极其精确的技术细节(如报错代码、文件路径、端口号等),并且最终只能输出干干净净的纯文本。
策略 1 处理的是”轮内的工具序列”——一轮里有大量工具调用时压它们,但保留 final assistant。 策略 4 处理的是”轮间的整体摘要”——把整轮(包括 final assistant)压成一条。
理论上策略 1 完成后再走策略 4,效果会更好(先压工具,再压整体)。但每次 compressIfNeeded 只生效一个策略,因为压缩本身有 LLM 调用开销,一次压一点然后等下一轮再判断阈值,避免一次性压过头。
第五级:当前轮大消息 LLM 摘要
如果前面4个策略都是失效了,那么也就意味着:没有连续工具序列可压、没有大消息可卸(或最近的不能卸)、历史轮次都太短不值得摘要——所有”压历史”的手段都用完了,但 token 还是超标。
这时只剩一个目标:当前轮(最近一条 user 之后的所有内容)。
1 | private boolean summaryCurrentRoundLargeMessages(List<Msg> rawMessages) { |
1 | private Msg generateLargeMessageSummary(Msg message, String offloadUuid) { |
本轮用到的默认提示词:
1 | “你是一位专业的内容压缩专家。你的任务是智能地总结以下消息内容。该消息超出了大小阈值,需要在保留所有关键信息的前提下进行压缩。重要提示: 此内容来自当前轮次。请在压缩时格外谨慎和保守。请尽可能多地保留以下内容,因为这些信息正在当前的对话中被积极使用。请提供一个简明扼要的总结,需满足以下要求:保留所有关键信息和核心细节。维持重要的上下文,以便未来参考。突出任何重要的结果、产出或状态信息。如果存在工具调用信息,请予以保留(包括工具名称、ID、关键参数)。” |
这段提示词,相比之前的压缩,它强调这次要压缩的内容是当前对话正在用的新鲜数据,所以 AI 绝对不能像处理历史记录那样大刀阔斧地删减。它要求 AI 采取“保守”策略,在缩减篇幅的同时,必须死死保住关键细节、上下文、执行结果以及工具调用的参数,防止因为压缩过度导致当前任务出错。
第六级:当前轮整体压缩
这是整个压缩过程最后的兜底了。走到策略 6 意味着:策略 5 也没生效——当前轮没有”单独超过阈值”的大消息,但当前轮整体仍然太大。这通常出现在”工具调用密集型”的当前轮:比如 Agent 连续调用了 10 个小工具,每个返回的数据都不大(不超过 5KB),但 10 个加起来就把上下文撑爆了。
策略 5 因为”每条都不超阈值”而无法处理,只能策略 6 来兜底。
这个压缩有一个特点,就是比例化压缩:
第一步算原始内容的总字符数(用 calculateMessagesCharCount 把所有 block 都算上)。
第二步用配置的 currentRoundCompressionRatio(默认 0.3)算出目标字符数 = 原始字符数 × 0.3。
第三步在 prompt 里直接告诉模型:”原始内容是 X 字符,目标压缩到 Y 字符(约 30%)”。
为什么要这么明确?因为兜底压缩往往面对的是”千变万化”的内容,让模型自由发挥可能压得过狠(核心信息丢失)或过轻(还是超阈值)。给个明确的字符数目标,结果可控性大大提高。
这轮压缩默认的提示词:
1 | “你是专为自主智能体(Autonomous Agents)设计的上下文整合专家。你的任务是将新的工具执行结果整合到当前的对话上下文中。输入结构:输入内容包含:(a) 可选的:一个先前的压缩上下文块,以 <!-- CONTEXT_OFFLOAD: uuid=... --> 结尾。(b) 紧接其后的是当前轮次中零个或多个交替出现的 tool_use(工具调用)和 tool_result(工具结果)消息。输入中不包含用户消息。与计划相关的工具已在上一级流程中被过滤掉。你的工作流程:如果输入中包含匹配 <!-- CONTEXT_OFFLOAD: uuid=... --> 的行:将该行之前的所有文本原封不动地保留为先前上下文。仅处理该行之后的 tool_use / tool_result 对。否则(未找到卸载标记):将全部输入视为第一轮压缩中的新工具交互。仅基于这些工具调用及其结果生成摘要。针对每一个 tool_use / tool_result 对:以第一人称的事实陈述进行总结:“我调用了 [tool_name],参数为 [arg1=value1, ...];返回结果:[关键细节]。”保留所有技术细节:文件路径、ID、错误代码、配置值、状态变更。如果结果被截断或格式错误,请将其逐字包含,并在前面加上 [UNPARSED OUTPUT](未解析的输出)前缀。输出要求:输出为一个纯文本块,包含:[先前上下文(如果有)]\n[新工具摘要]不要在输出中包含任何 <!-- CONTEXT_OFFLOAD --> 标签。不要提及用户的请求、意图或问题(因为输入中根本没有这些内容)。不要使用 Markdown、JSON、项目符号,也不要使用诸如“如前所述”、“新操作:”之类的短语。该输出将作为新的压缩上下文,新的卸载标签将在外部追加。可以从 tool_result 中安全删除的内容:样板文本(如许可证声明、自动生成的注释)。没有任何可操作数据的冗余成功提示。重复的日志前缀(前提是核心内容已保留)。严格禁止:包含原始的 tool_use / tool_result JSON 数据。重新压缩或修改先前的上下文。添加任何卸载标记(无论是旧的还是新的)。” |
这段话是给 AI 的“上下文拼接说明书”。它告诉 AI 如何把“历史记忆”和“刚刚干完的活”无缝拼在一起。AI 需要识别一个特殊的分割线(CONTEXT_OFFLOAD),先把上面的历史一字不改地保留,线下面的新工具调用则用第一人称(“我调用了…”)进行精简总结。同时,它要求 AI 像过滤器一样,自动剔除日志里的废话和样板代码,只留下硬核的技术细节,并且最终只能输出干干净净的纯文本。
压缩不是永久丢失
六级策略有一个共同特征:所有被压缩或卸载的内容都通过 UUID 存在 offloadContext(Map) 里,可以通过 ContextOffloadTool 这个工具调回来。
这意味着压缩不是”永久丢失”,而是”懒加载”。Agent 在 working memory 里看到 <context_offload uuid=”xxx”/> 标签时,知道这里有原文存在但被搬走了。如果它判断后续推理需要原文细节(比如用户突然问”你刚才查到的第 3 条航班具体几点起飞”),就调用 context_offload(uuid=”xxx”) 把内容拉回来插入对话。
这是 AutoContextMemory 与传统”上下文截断”的本质差异。截断是单向的、信息丢失的;卸载是双向的、信息保留的。代价是要存储和工具调用,但收益是 Agent 永远可以回到任意压缩点查阅原文。
做个总结
如果用一句话概括:先压历史不调 LLM,再压历史调 LLM,最后压当前调 LLM;先压结构性强的(工具序列),再压结构性弱的(自由文本);所有压缩都可逆,所有结构都保留,所有边界都谨慎。
具体到每一级:
策略 1 优先收割工具调用——这是 ReAct 场景下 token 占比最大的一类内容,结构清晰可压,调一次 LLM 就能换来巨大收益。
策略 2/3 用纯字符串操作处理大单条消息——零 LLM 开销,零延迟,主要解决”长文档/大附件”被反复占用上下文的问题。策略 2 比策略 3 多了”最近 50 条保护”的稳健兜底。
策略 4 用 LLM 摘要历史轮次——处理”零碎多轮累积”型对话,把整轮压成一句话,保留 user 锚点维持对话流。
策略 5 用 LLM 摘要当前轮的单条大消息——结构精细保留,避免破坏 ToolUse/ToolResult 配对,是当前轮处理里相对温和的方式。
策略 6 终极兜底——把当前轮整体按比例压缩,副作用最大但保证总能压下去。
最后所有压缩都通过 UUID 存档,可通过工具调用按需恢复。这套设计让 AutoContextMemory 成为长对话场景下”几乎无感”的上下文管家——它在背后悄悄运转,让模型永远不会触碰到上下文窗口的硬上限,同时又保留了完整的原始历史可供回溯。